标准差是什么?标准差怎么算?与方差的区别及n-1的由来
本文在AI辅助下由原文翻译而成。请结合原文核对专业术语和公式。
标准差(也叫标准偏差,缩写SD)表示数据与平均数之间的典型距离,单位和原数据相同:标准差小,数据紧紧围绕平均数;标准差大,数据就很分散。计算时,先求每个数据与平均数的差,平方后取平均得到方差,再开平方即可。如果手里的数据就是你要研究的全部对象,离差平方和除以n(Excel用STDEV.P);如果只是从更大群体中抽出的样本,则除以n − 1(Excel用STDEV.S)。
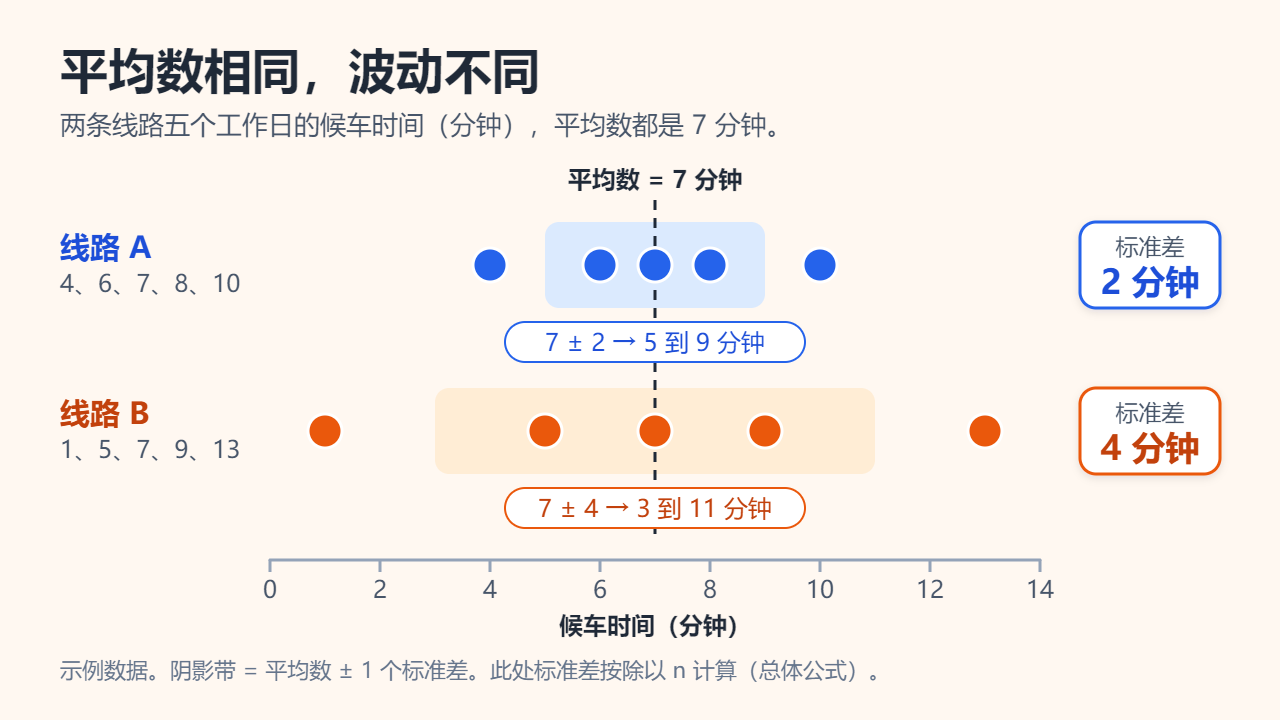
平均数相同,数据的波动却可以完全不同
假设你记录了一周五个工作日等两条公交线路的候车时间(示例数字)。线路A:4、6、7、8、10分钟;线路B:1、5、7、9、13分钟。两条线路的平均数(均值)都恰好是7分钟,只看平均数,它们毫无区别。可实际体验完全不同:线路A很稳定,线路B却在1分钟到13分钟之间大幅摆动。
标准差就是把这种差别量化:线路A是2分钟,线路B是4分钟,说明线路B围绕同一个平均数的波动更大,约为线路A的两倍。严格地说,标准差是“均方根距离”而不是普通的平均距离,所以离平均数越远的数据,影响越大。
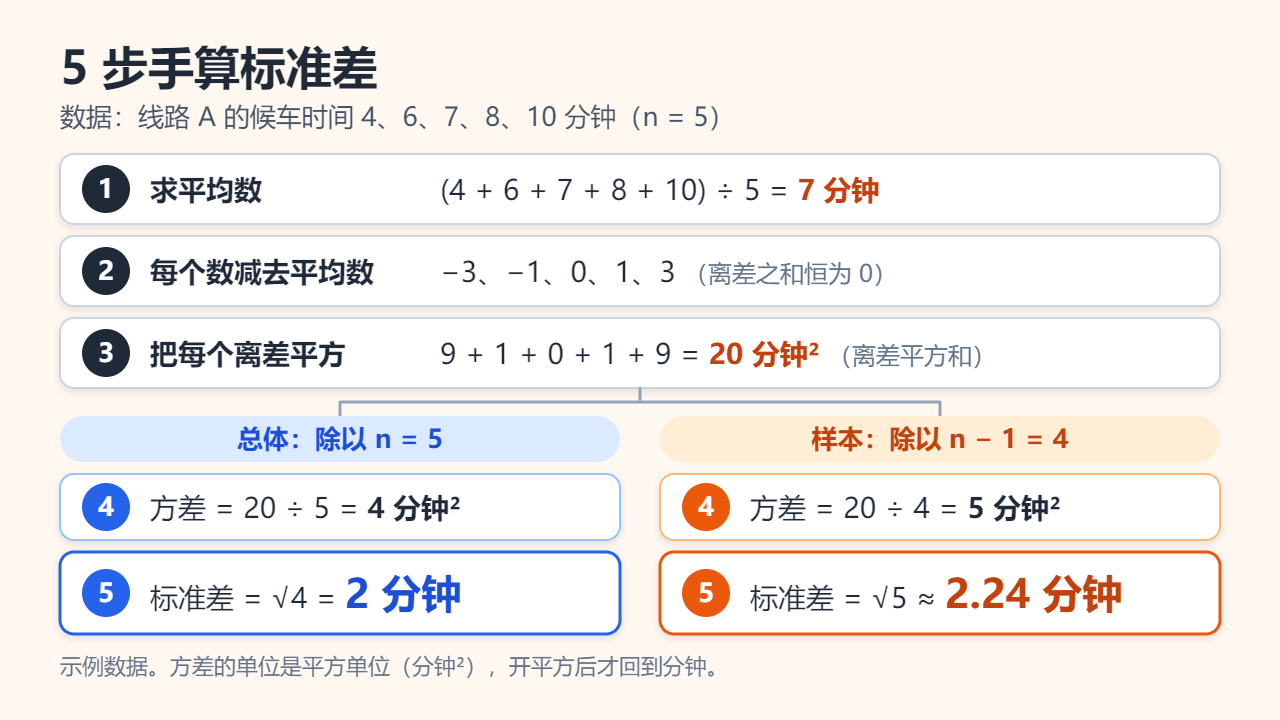
标准差怎么算:5步手算示例
- 求平均数。(4 + 6 + 7 + 8 + 10) ÷ 5 = 35 ÷ 5 = 7分钟。
- 每个数减去平均数。得到的差(离差)是−3、−1、0、1、3。它们的和永远是0,所以不能直接求平均。
- 把每个离差平方。得9、1、0、1、9,平方去掉了负号,总和20叫离差平方和。
- 除以一个数,得到方差。这五天若是你关心的全部数据(总体),算20 ÷ 5 = 4;若只是样本,算20 ÷ 4 = 5(原因见下文)。
- 开平方。√4 = 2分钟,或√5 ≈ 2.24分钟。
| 等待时间(分钟) | 与平均数7的差(离差) | 离差的平方(分钟²) |
|---|---|---|
| 4 | −3 | 9 |
| 6 | −1 | 1 |
| 7 | 0 | 0 |
| 8 | 1 | 1 |
| 10 | 3 | 9 |
| 合计:35 | 0 | 20 |
线路B的算法完全一样:离差为−6、−2、0、2、6,离差平方和为80,80 ÷ 5 = 16,标准差 = √16 = 4分钟。
方差和标准差的区别:为什么先平方、再开方?
方差本质上就是离差平方的平均值,标准差则是方差的算术平方根。二者信息相同,只是单位不同。线路A的方差是4“平方分钟”,很难直观想象;标准差是2分钟,可以直接和7分钟的平均数对照。美国国家标准与技术研究院(NIST)的《工程统计手册》也这样解释:开平方是为了回到原来的单位。
那为什么要先平方?因为正负离差会互相抵消,必须先去掉符号;平方还会让偏离大的数据占更大比重。若改为对离差的绝对值求平均(平均绝对偏差),线路A得8 ÷ 5 = 1.6分钟,比标准差2分钟小,因为标准差更看重±3这两个离得最远的值。方差则胜在便于运算:相互独立的量,方差可以直接相加。
- 汇报结果用标准差:读者要用分钟、分数这类实际单位理解波动时。
- 公式推导用方差:在模型和统计检验里,方差更便于相加与拆分。
总体标准差(除以n)还是样本标准差(除以n − 1)?
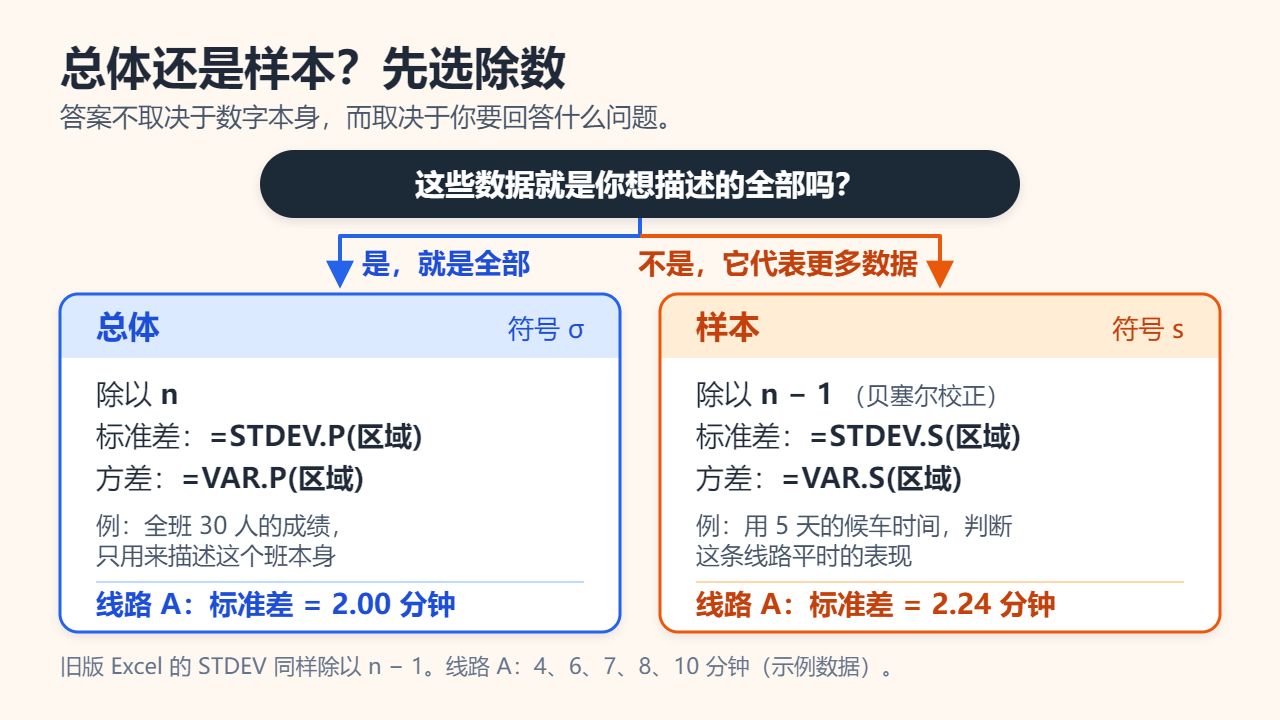
选哪个除数,取决于你要回答的问题,而不是这几个数字本身。如果这五天就是你想描述的全部对象,它们就是总体:除以n,符号用σ。如果你想借这五天判断线路A平时的表现,它们就只是从大量日子中抽出的样本:除以n − 1,符号用s。
除以n − 1的做法叫贝塞尔校正(Bessel’s correction)。样本里的离差是相对样本自己的平均数算的,而样本平均数天然落在这几个数据的“中间”,所以算出的离差会比以未知的真实平均数为基准时略小。若仍除以n,方差平均而言只有真实值的(n − 1) ÷ n倍,即被低估;改除以n − 1,这个偏差就被消除,得到的样本方差是总体方差的无偏估计。
| 项目 | 总体 | 样本 |
|---|---|---|
| 离差平方和除以 | n | n − 1 |
| 常用符号 | σ | s |
| 常见叫法 | 总体方差、总体标准差 | 样本方差、样本标准差 |
| Excel标准差函数 | STDEV.P | STDEV.S(旧版:STDEV) |
| Excel方差函数 | VAR.P | VAR.S |
| 线路A的结果 | 2.00分钟 | 2.24分钟 |
叫法在不同教材里并不统一:有的教材把除以n的结果也称作“样本方差”。所以看公式时不要只看名字,先看分母是n还是n − 1。
在Excel里,若五个等待时间放在A2:A6,=STDEV.P(A2:A6)返回2,=STDEV.S(A2:A6)返回约2.236。中文版Excel的函数名不翻译,仍是STDEV.S、STDEV.P;微软中文文档把标准差称为“标准偏差”。按微软的说明,这两个函数对引用的单元格区域都会忽略空白单元格、文本和逻辑值,所以以文本形式存放的数字会被悄悄漏算。
两种算法到底差多少?
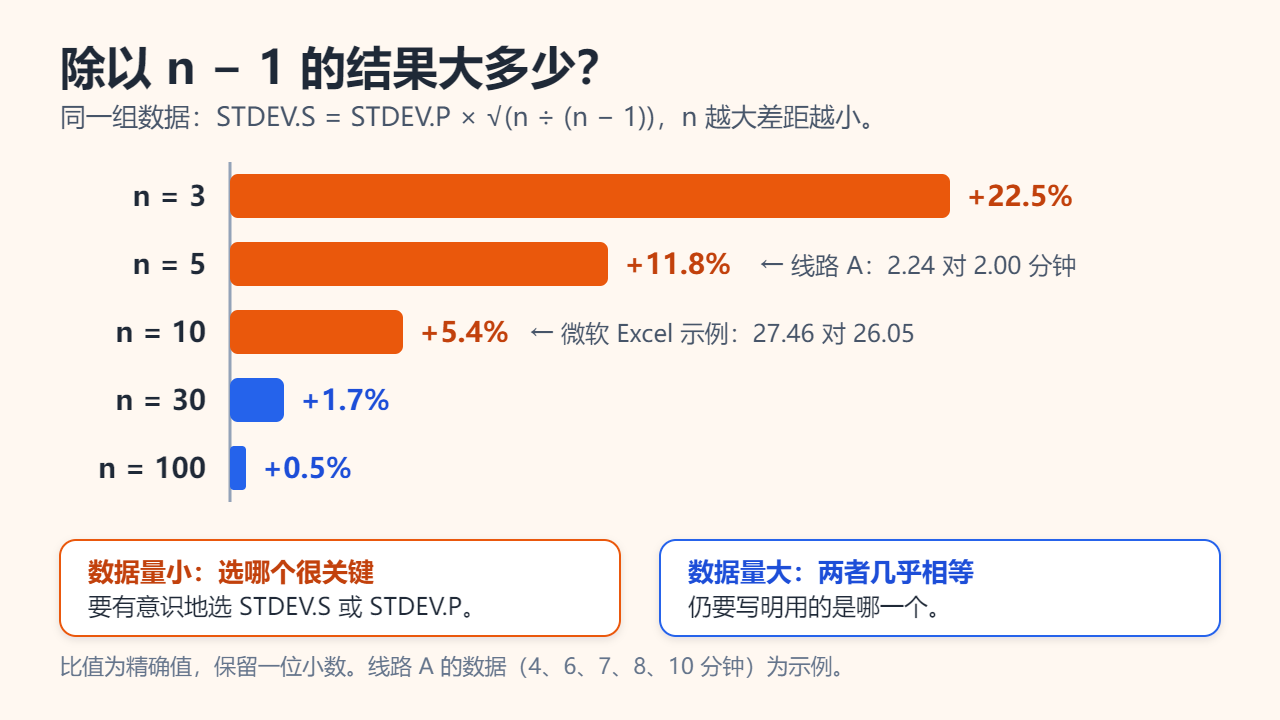
对同一组数据,样本标准差是总体标准差的√(n ÷ (n − 1))倍:n = 3时大22.5%,n = 5时大11.8%,n = 10时大5.4%,n = 30时大1.7%,n = 100时只大0.5%。微软文档里10个断裂强度数据的示例正是n = 10:STDEV.S返回27.46,STDEV.P返回26.05。
实际中怎么解读标准差
读标准差要连同平均数和单位一起看。7分钟的平均等待配上2分钟的标准差,相对波动已经不小;同样的2分钟,放在60分钟的通勤时间上就微不足道。用标准差除以平均数,得到变异系数,比较就一目了然:线路A是2 ÷ 7 ≈ 29%,线路B是4 ÷ 7 ≈ 57%。
当数据大致呈钟形(正态分布)时,标准差还能告诉你大多数数据落在哪个范围。据NIST,正态总体中有68.27%的数据落在平均数±1个标准差内,95.45%落在±2个标准差内,99.73%落在±3个标准差内。比如钟形的考试成绩平均分70、标准差10(示例数字),约三分之二的人在60到80分之间。收入、带长尾的等待时间这类偏斜数据则不适用这条法则。
常见误区
- 用STDEV.P处理小样本。会低估波动:n = 5时,STDEV.S的结果高出11.8%。
- 把方差当成标准差汇报。方差4分钟²对应的标准差是2分钟,不是4分钟。
- 忽视异常值。离差要平方,一个极端值就可能左右结果。把线路A的10改成20,总体标准差会从2分钟跳到约5.66分钟。
- 把68–95–99.7法则套在偏斜数据上。先看直方图再决定。
- 混淆标准差与标准误。均值的标准误s ÷ √n说明平均数估得有多准,而不是单个数据有多分散。线路A的标准误是2.24 ÷ √5 ≈ 1.0分钟。
常见问题
标准差可以是负数吗?
不可以。它是“平方的平均数”再开平方,最小值是0,而且只有所有数据完全相同时才等于0。
标准差就是平均偏差吗?
不是。平均绝对偏差是把距离本身直接取平均,标准差则是先平方、取平均、再开方。对线路A来说,两者分别是1.6分钟和2分钟。
算班级的考试成绩,该用哪个函数?
只想描述这个班本身,就用STDEV.P;如果把这个班看作全体学生中的一个样本,就用STDEV.S。
资料来源:NIST工程统计手册:尺度度量(英文);NIST工程统计手册:什么是“正态”数据(英文);Microsoft支持:STDEV.S函数;Microsoft支持:STDEV.P函数
相关阅读
为帮助理解本文而制作的原创插画。