표준편차란? 구하는 법, 분산과의 차이, n-1로 나누는 이유
이 글은 AI의 도움을 받아 원문을 번역한 글입니다. 전문 용어와 수식은 원문과 함께 확인해 주세요.
표준편차는 값들이 평균에서 보통 얼마나 떨어져 있는지를 데이터와 같은 단위로 나타낸 수치입니다. 표준편차가 작으면 값들이 평균 근처에 촘촘히 모여 있다는 뜻이고, 크면 넓게 흩어져 있다는 뜻입니다. 각 값에서 평균을 빼 편차를 구하고, 편차를 제곱해 평균을 낸 값이 분산이며, 그 제곱근이 표준편차입니다. 가진 숫자가 관심 있는 집단 전체라면 n으로(엑셀 STDEV.P), 더 큰 집단을 대표하는 표본이라면 n−1로(STDEV.S) 나눕니다.
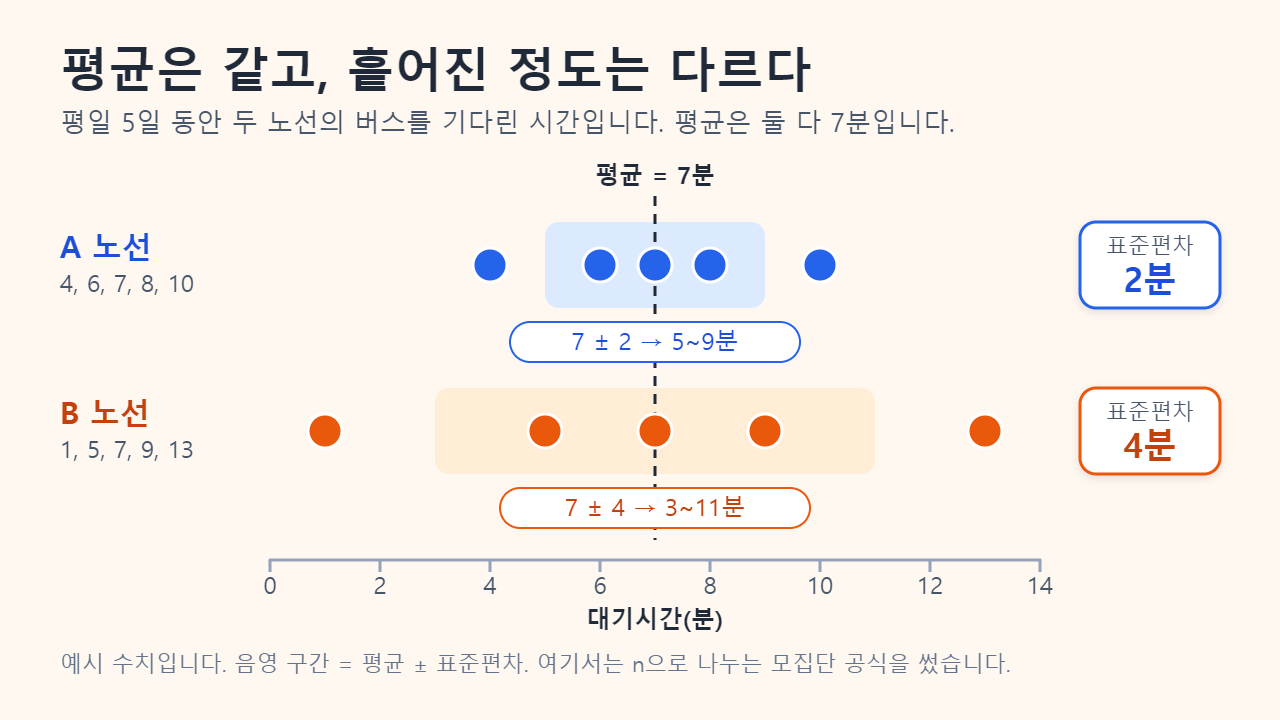
평균은 같은데 흩어진 정도가 다른 경우
평일 닷새 동안 버스 두 노선을 기다린 시간을 기록했다고 가정해 보겠습니다(예시 수치). A 노선은 4, 6, 7, 8, 10분이고 B 노선은 1, 5, 7, 9, 13분입니다. 두 노선 모두 평균이 정확히 7분이라서 평균만 보면 똑같은 노선처럼 보입니다. 하지만 A 노선은 대기시간을 예측하기 쉬운 반면, B 노선은 1분 만에 타는 날도 있고 13분이나 기다리는 날도 있습니다.
표준편차는 이 차이를 숫자 하나로 보여 줍니다. A 노선의 표준편차는 2분, B 노선은 4분이므로, 같은 평균을 기준으로 B 노선의 대기시간이 두 배 넓게 퍼져 있다고 읽을 수 있습니다. 엄밀히 말하면 표준편차는 단순한 거리 평균이 아니라 제곱평균제곱근(RMS) 거리입니다. 그래서 평균에서 멀리 떨어진 값에 더 큰 비중이 실립니다.
표준편차 구하는 법: 5단계로 손계산하기
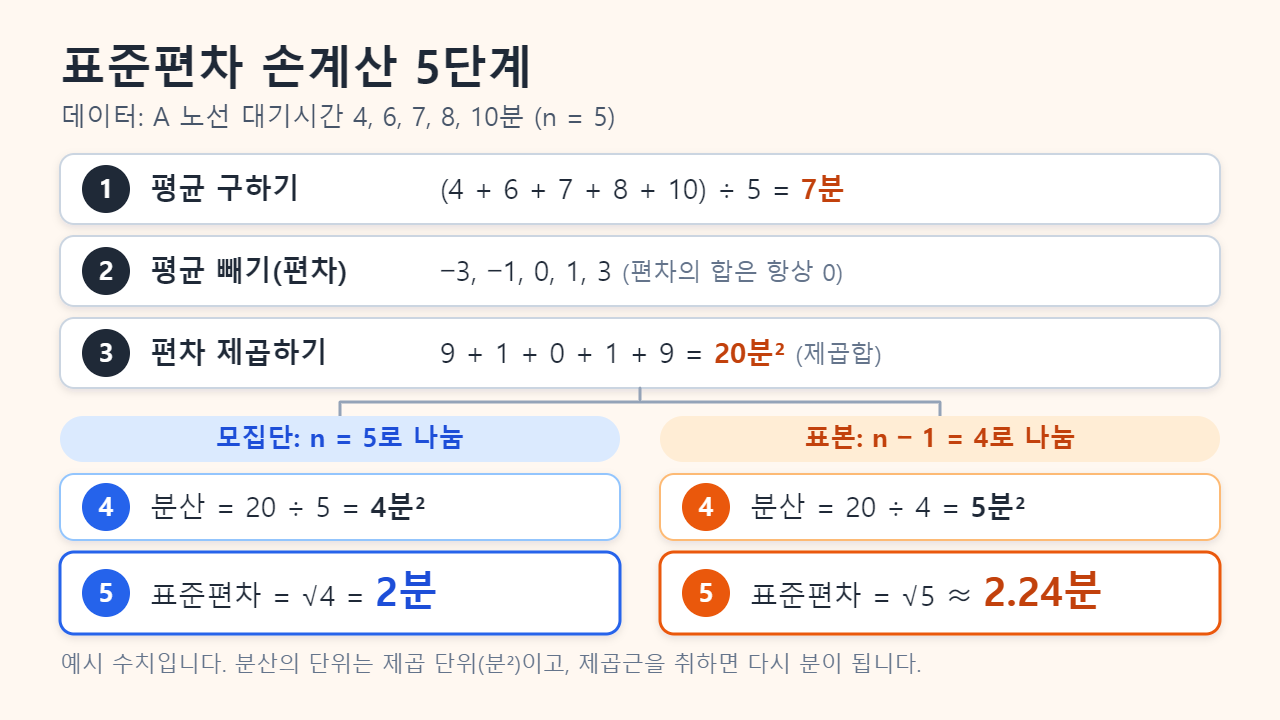
A 노선의 대기시간 4, 6, 7, 8, 10분으로 직접 계산해 보겠습니다.
- 평균을 구합니다. (4 + 6 + 7 + 8 + 10) ÷ 5 = 35 ÷ 5 = 7분입니다.
- 각 값에서 평균을 뺍니다. 이렇게 구한 편차는 −3, −1, 0, 1, 3입니다. 편차의 합은 언제나 0이 되기 때문에 편차를 그대로 평균 낼 수는 없습니다.
- 편차를 제곱합니다. 9, 1, 0, 1, 9가 됩니다. 제곱하면 마이너스 부호가 사라집니다. 이 값들의 합 20을 제곱합(편차 제곱합)이라고 부릅니다.
- 나누어서 분산을 구합니다. 닷새 기록이 관심 있는 대상 전체(모집단)라면 20 ÷ 5 = 4, 표본이라면 20 ÷ 4 = 5입니다(뒤에서 자세히 설명합니다).
- 제곱근을 취합니다. √4 = 2분, 또는 √5 ≈ 2.24분입니다.
| 대기시간(분) | 7과의 편차 | 편차 제곱(분²) |
|---|---|---|
| 4 | −3 | 9 |
| 6 | −1 | 1 |
| 7 | 0 | 0 |
| 8 | 1 | 1 |
| 10 | 3 | 9 |
| 합계: 35 | 0 | 20 |
B 노선도 같은 방식으로 계산합니다. 편차는 −6, −2, 0, 2, 6이고 제곱의 합은 80입니다. 80 ÷ 5 = 16이므로 표준편차는 √16 = 4분입니다.
분산과 표준편차의 차이: 왜 제곱했다가 제곱근을 취할까?
분산은 쉽게 말해 편차 제곱의 평균이고, 표준편차는 그 제곱근입니다. 두 값은 같은 정보를 단위만 바꿔 담고 있습니다. A 노선의 분산은 4 “제곱분(분²)”이라 감을 잡기 어렵지만, 표준편차 2분은 평균 7분과 곧바로 견줄 수 있습니다. 미국 NIST의 공학 통계 핸드북도 제곱근을 취하면 원래 데이터의 단위로 돌아온다고 설명합니다.
그렇다면 애초에 왜 제곱할까요? 양의 편차와 음의 편차는 서로 상쇄되므로 부호를 없애는 과정이 필요합니다. 제곱은 부호를 없애면서 동시에 큰 편차에 더 큰 비중을 줍니다. 편차의 절댓값을 평균 내는 방법도 있는데, 이를 평균절대편차라고 합니다. A 노선의 평균절대편차는 8 ÷ 5 = 1.6분으로 표준편차 2분보다 작습니다. 표준편차는 ±3분짜리 값에 더 크게 반응하기 때문입니다. 그래도 분산이 널리 쓰이는 이유는 수학적으로 다루기 편해서입니다. 서로 독립인 변수들의 분산은 그냥 더하면 됩니다.
- 표준편차가 알맞은 경우: 분, 점수, kg처럼 실제 단위로 흩어진 정도를 읽어야 할 때입니다.
- 분산이 알맞은 경우: 수식, 모형, 통계 검정처럼 분산을 더하고 쪼개는 일이 많을 때입니다.
모집단(n)과 표본(n−1): 어떤 공식을 써야 할까?
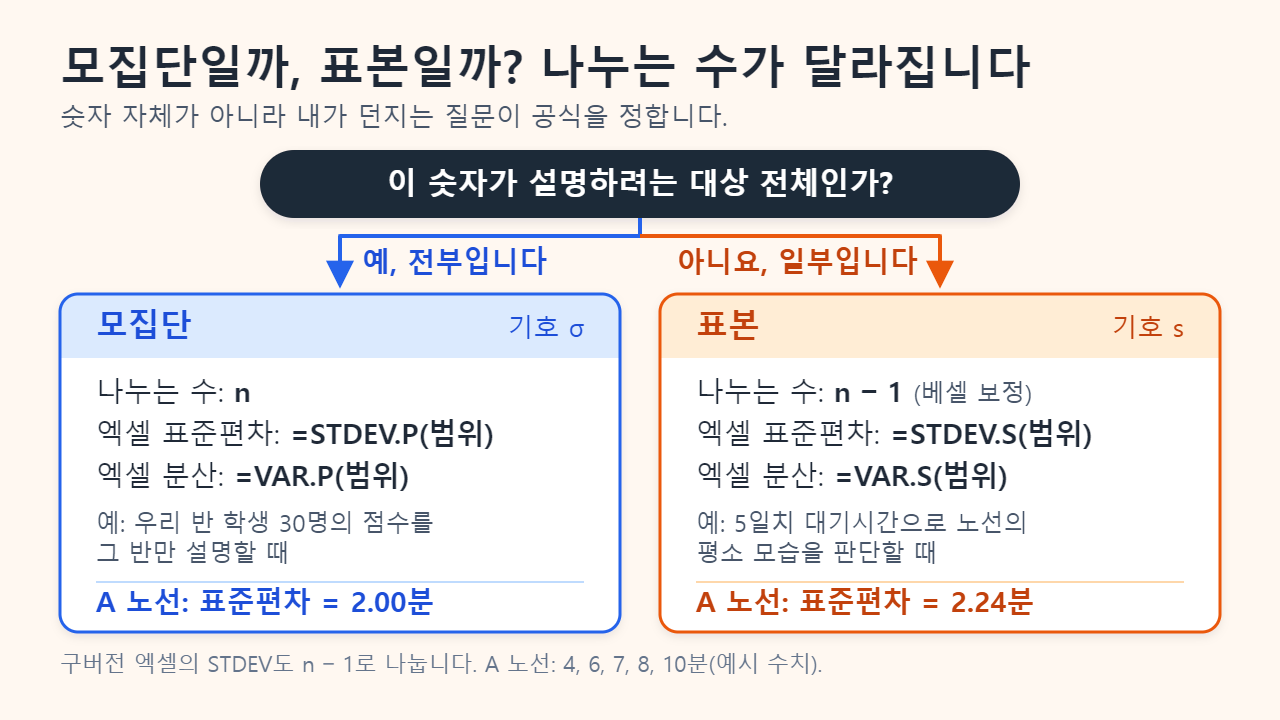
무엇으로 나눌지는 숫자가 아니라 질문이 정합니다. 이 글에서는 n으로 나눈 값을 모분산·모표준편차, n−1로 나눈 값을 표본분산·표본표준편차라고 부르겠습니다. 닷새 기록이 설명하려는 대상의 전부라면(“지난주 내 대기시간은 어땠나?”) 모집단이므로 n으로 나누고, 기호는 σ(시그마)를 씁니다. 반대로 이 닷새를 근거로 A 노선이 평소에 어떤지 판단하려는 것이라면 훨씬 많은 날 가운데 뽑은 표본이므로 n−1로 나누고, 기호는 s를 씁니다.
n−1로 나누는 방법을 베셀 보정(Bessel's correction)이라고 합니다. 표본의 편차는 표본 자신의 평균을 기준으로 잽니다. 그런데 표본 평균은 그 값들의 한가운데에 놓이도록 정해지는 값이라서, 실제 평균(우리가 모르는 모평균)에서 잰 편차보다 조금 작게 나옵니다. 그래서 n으로 나누면 분산이 평균적으로 실제 값의 (n−1)/n배로 작게 추정되고, n−1로 나누면 이 치우침이 사라집니다.
| 항목 | 모집단 | 표본 |
|---|---|---|
| 제곱합을 나누는 수 | n | n−1 |
| 보통 쓰는 기호 | σ | s |
| 엑셀 표준편차 함수 | STDEV.P | STDEV.S (구버전: STDEV) |
| 엑셀 분산 함수 | VAR.P | VAR.S |
| A 노선 결과 | 2.00분 | 2.24분 |
엑셀에서 표준편차 구하는 순서
- A2:A6 셀에 4, 6, 7, 8, 10을 입력합니다.
- 닷새 기록이 대상의 전부라면 빈 셀에
=STDEV.P(A2:A6)을 입력하고 Enter를 누릅니다. 결과는 2입니다. - 표본이라면
=STDEV.S(A2:A6)을 입력합니다. 결과는 약 2.236이며, 소수 둘째 자리까지 표시하면 2.24입니다. - 분산이 필요하면
=VAR.P(A2:A6)(결과 4) 또는=VAR.S(A2:A6)(결과 5)를 씁니다.
한국어 버전 엑셀에서도 함수 이름은 영문 그대로 입력합니다. 마이크로소프트 설명서에 따르면 두 함수 모두 참조한 범위 안의 빈 셀, 텍스트, 논리값은 무시합니다. 그래서 텍스트로 저장된 숫자는 오류 없이 조용히 계산에서 빠집니다.
n과 n−1 중 무엇을 쓰느냐에 따라 얼마나 달라질까?
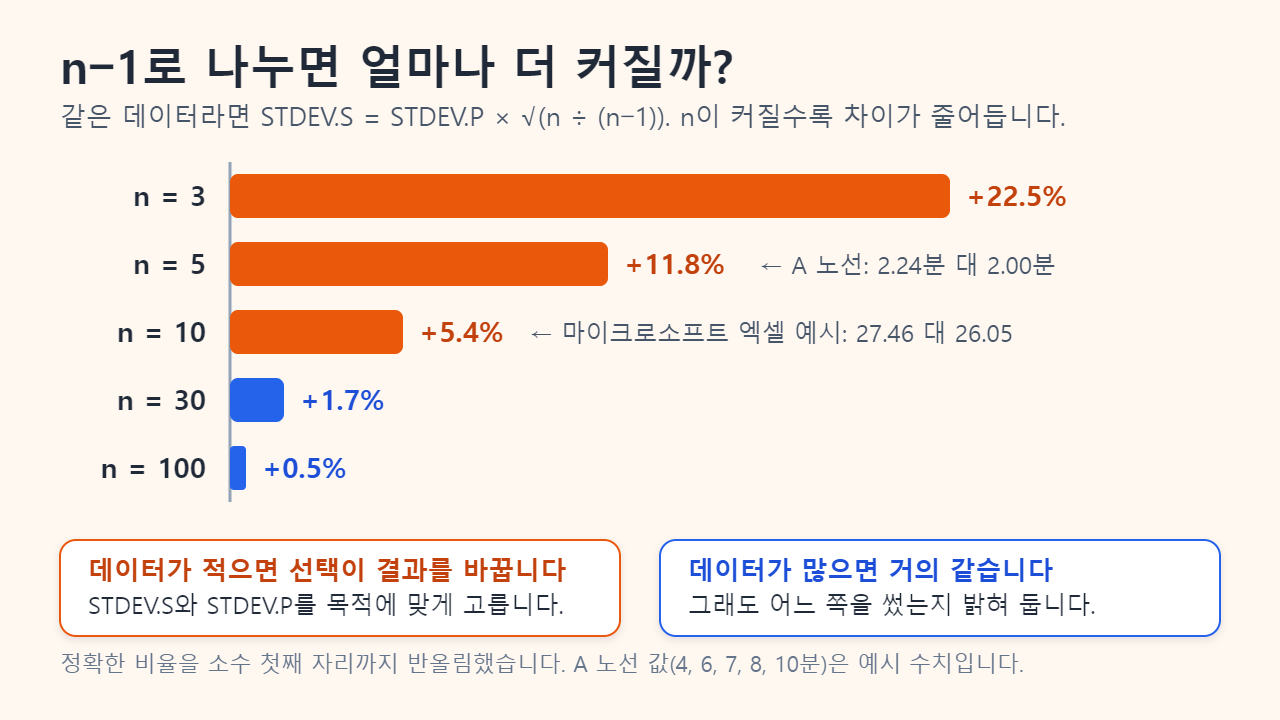
같은 데이터라면 표본표준편차는 모표준편차의 √(n ÷ (n−1))배입니다. 계산해 보면 n = 3일 때 22.5%, n = 5일 때 11.8%, n = 10일 때 5.4%, n = 30일 때 1.7%, n = 100일 때 0.5% 더 큽니다. 마이크로소프트 설명서의 10개 값 예제가 n = 10인 경우입니다. STDEV.S는 27.46, STDEV.P는 26.05를 돌려줍니다.
표준편차 해석하는 법: 평균·단위와 함께 읽기
표준편차는 반드시 평균, 단위와 함께 읽어야 합니다. 평균 7분에 표준편차 2분이면 상대적으로 변동이 큰 편이지만, 60분 걸리는 출퇴근길에서 같은 2분은 아주 작은 변동입니다. 표준편차를 평균으로 나눈 값, 즉 변동계수를 쓰면 이 차이가 분명해집니다. A 노선은 2 ÷ 7 ≈ 29%, B 노선은 4 ÷ 7 ≈ 57%입니다.
데이터가 대체로 종 모양(정규분포)이라면 표준편차로 대부분의 값이 어디에 놓이는지도 가늠할 수 있습니다. NIST에 따르면 정규분포를 따르는 모집단의 68.27%는 평균 ±1 표준편차 안에, 95.45%는 ±2 표준편차 안에, 99.73%는 ±3 표준편차 안에 들어갑니다. 평균 70점, 표준편차 10점인 종 모양 시험 점수(예시 수치)라면 약 3분의 2가 60~80점 사이에 있다고 볼 수 있습니다. 다만 소득이나 꼬리가 긴 대기시간처럼 한쪽으로 치우친 데이터에서는 이 법칙이 맞지 않습니다.
표준편차 계산할 때 흔한 실수
- 표본이 작은데 STDEV.P를 쓰는 경우. 흩어진 정도를 실제보다 작게 추정합니다. n = 5이면 STDEV.S가 11.8% 더 크게 나옵니다.
- 분산을 표준편차인 것처럼 쓰는 경우. 분산 4분²은 표준편차 2분이지 4분이 아닙니다.
- 이상치를 살펴보지 않는 경우. 편차를 제곱하기 때문에 극단적인 값 하나가 결과를 좌우할 수 있습니다. A 노선의 10을 20으로 바꾸면 모표준편차가 2분에서 약 5.66분으로 뛰어오릅니다.
- 치우친 데이터에 68–95–99.7 법칙을 적용하는 경우. 쓰기 전에 히스토그램부터 확인하는 편이 안전합니다.
- 표준편차와 표준오차를 혼동하는 경우. 평균의 표준오차 s ÷ √n은 평균이 얼마나 정밀하게 추정되었는지를 나타낼 뿐, 개별 값이 얼마나 흩어져 있는지를 나타내지 않습니다. A 노선은 2.24 ÷ √5 ≈ 1.0분입니다.
자주 묻는 질문
표준편차가 음수가 될 수 있나요?
될 수 없습니다. 제곱의 평균에 제곱근을 취한 값이므로 가장 작은 값은 0이고, 0이 되는 경우는 모든 값이 똑같을 때뿐입니다.
표준편차와 평균절대편차는 같은 건가요?
다릅니다. 평균절대편차는 거리 자체를 평균 내고, 표준편차는 거리를 제곱해 평균 낸 뒤 제곱근을 취합니다. A 노선에서는 각각 1.6분과 2분입니다.
우리 반 시험 점수에는 STDEV.P와 STDEV.S 중 무엇을 써야 하나요?
그 반만 설명하려는 것이라면 STDEV.P를 씁니다. 그 반을 학생 전체의 표본으로 본다면 STDEV.S를 씁니다.
출처: NIST e-Handbook: 산포의 측도(Measures of Scale); NIST e-Handbook: “정규” 데이터란 무엇인가; Microsoft 지원: STDEV.S 함수; Microsoft 지원: STDEV.P 함수
함께 읽으면 좋은 글
본문의 이해를 돕기 위해 제작한 설명용 삽화입니다.