標準偏差とは?求め方と分散との違い、n−1で割る理由を例題で解説
この記事はAIの支援を受けて原文を翻訳したものです。専門用語や数式は原文とあわせて確認してください。
標準偏差とは、データが平均値から「ふつうどれくらい離れているか」を、元のデータと同じ単位で表した値です。小さいほど平均のまわりにデータが集まっていて、大きいほど散らばっています。求め方は、各データから平均を引き、それを2乗して平均をとり(これが分散)、最後に平方根をとるだけです。分散を求める割り算では、手元のデータが知りたい集団の「すべて」なら n で割り(Excel の STDEV.P)、大きな集団から取り出した「標本」なら n−1 で割ります(STDEV.S)。
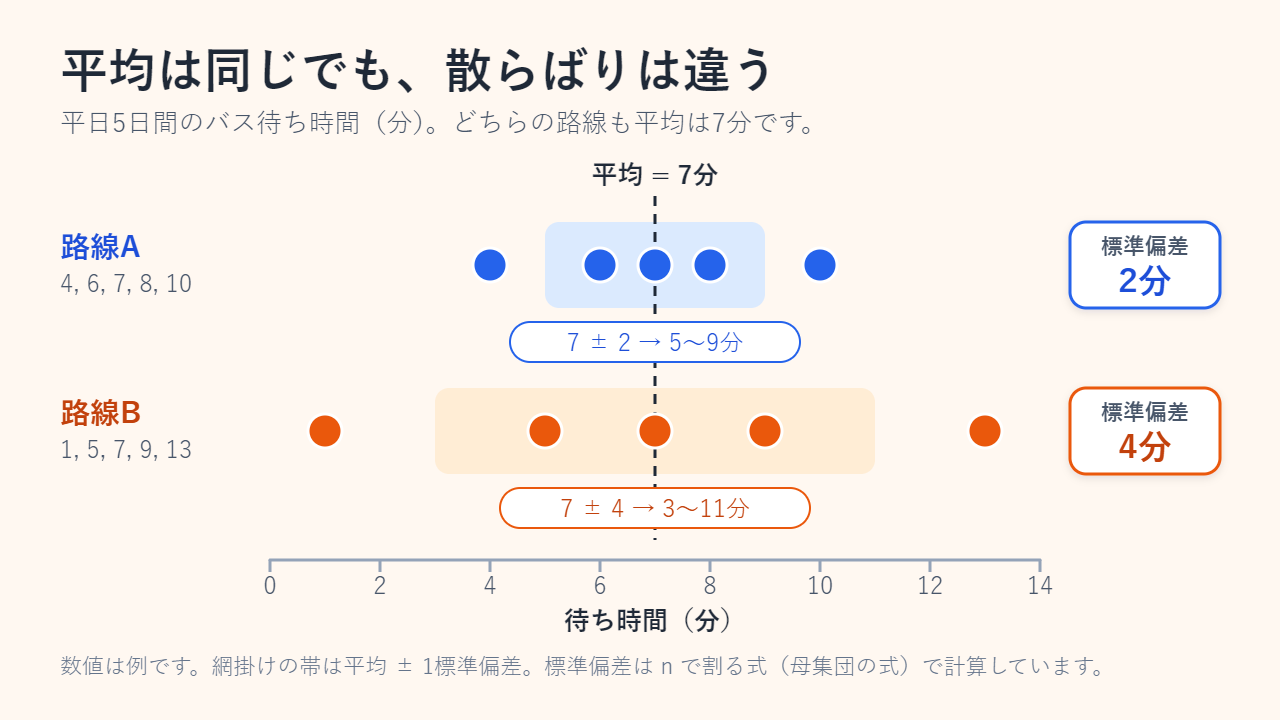
平均が同じでも散らばりは違う
平日5日間、2つのバス路線の待ち時間を記録したとします(例として作った数値です)。路線Aは4分、6分、7分、8分、10分。路線Bは1分、5分、7分、9分、13分です。どちらも平均はちょうど7分なので、平均だけを見ると2つの路線は同じに見えます。しかし実際には、路線Aは待ち時間がほぼ読めるのに対し、路線Bは1分で来る日もあれば13分かかる日もあります。
この違いを1つの数字にしたものが標準偏差です。路線Aは2分、路線Bは4分で、同じ平均のまわりで路線Bのほうが2倍広く散らばっていることがわかります。厳密には、標準偏差は「距離の単純な平均」ではなく、2乗して平均してから平方根をとった「2乗平均平方根」にあたります。そのため、平均から遠いデータほど大きく効いてきます。
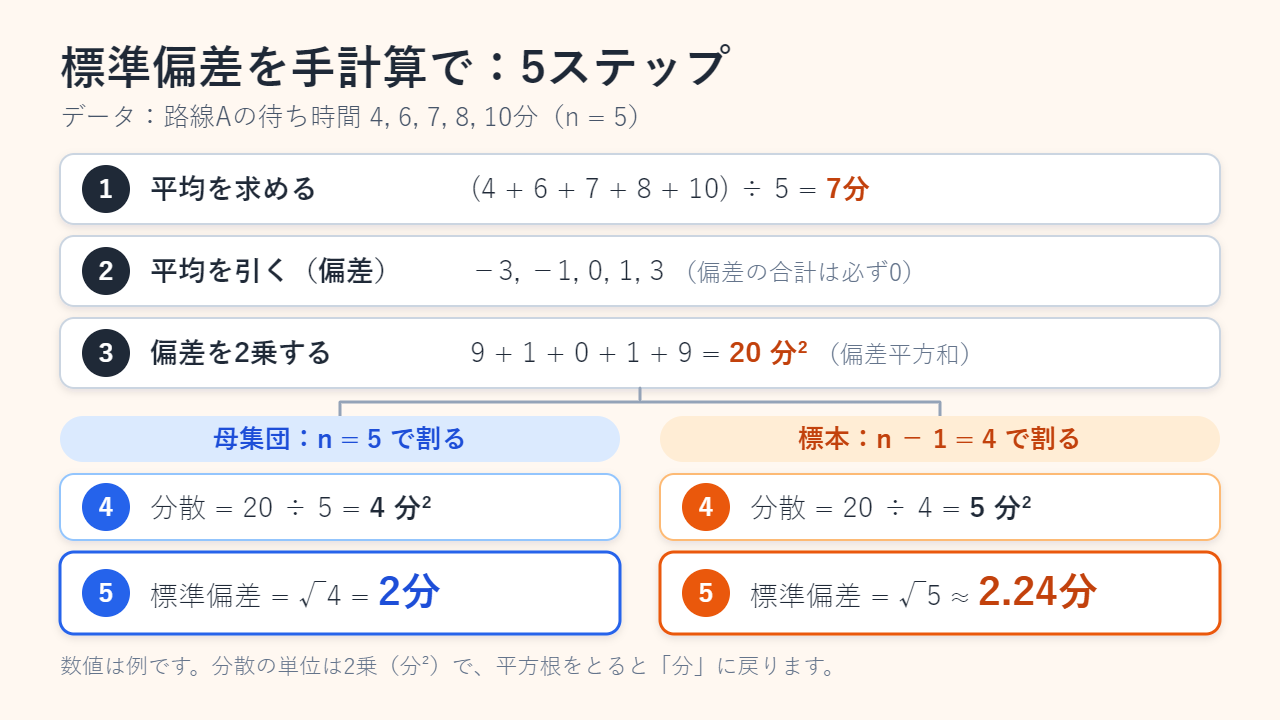
標準偏差の求め方を5ステップで解説
- 平均を求める。(4 + 6 + 7 + 8 + 10) ÷ 5 = 35 ÷ 5 = 7分。
- 各データから平均を引く(偏差を出す)。偏差は −3、−1、0、1、3 です。偏差は必ず合計が0になるため、そのまま平均しても散らばりはわかりません。
- 偏差を2乗する。9、1、0、1、9。2乗するとマイナスが消えます。この合計の20を偏差平方和(平方和)といいます。
- 割り算をして分散を出す。5日分が知りたい対象のすべて(母集団)なら 20 ÷ 5 = 4、標本として扱うなら 20 ÷ 4 = 5 です(違いは後述)。
- 平方根をとる。√4 = 2分、または √5 ≈ 2.24分。
| 待ち時間(分) | 平均7分との差(偏差) | 偏差の2乗(分²) |
|---|---|---|
| 4 | −3 | 9 |
| 6 | −1 | 1 |
| 7 | 0 | 0 |
| 8 | 1 | 1 |
| 10 | 3 | 9 |
| 合計:35 | 0 | 20 |
路線Bも同じ手順です。偏差は −6、−2、0、2、6、2乗の合計は80、80 ÷ 5 = 16 なので、標準偏差は √16 = 4分になります。
分散と標準偏差の違い:なぜ2乗して、平方根をとるのか
分散は「偏差の2乗の平均」、標準偏差はその平方根です。この2つは、同じ情報を違う単位で表したものです。路線Aの分散は4「分²(平方分)」で、直感的にイメージしにくい単位です。標準偏差なら2分となり、平均の7分と直接比べられます。NIST(米国国立標準技術研究所)の統計ハンドブックも、平方根をとることで散らばりの単位が元のデータの単位に戻る、と説明しています。
そもそも、なぜ2乗するのでしょうか。偏差はプラスとマイナスが打ち消し合って合計0になるので、符号を消す操作が必要です。2乗すれば符号が消えるうえ、大きく外れたデータほど強く反映されます。符号を消す別の方法が、偏差の絶対値を平均する「平均絶対偏差(平均偏差)」で、路線Aなら 8 ÷ 5 = 1.6分です。±3 のデータを重く扱わない分、標準偏差の2分より小さくなります。それでも分散が広く使われるのは、独立した量どうしの分散が単純に足し算できるなど、数学的に扱いやすいからです。
- 標準偏差を報告する場面:分・点・kg など実際の単位で散らばりを読んでもらいたいとき。
- 分散を使う場面:数式・モデル・統計的検定の内部など、足したり分解したりしたいとき。
母集団(n で割る)と標本(n−1 で割る):どちらの式を使う?
割る数は、数字ではなく「何を知りたいか」で決まります。5日間の待ち時間そのものを説明したいなら、その5日分が対象のすべてなので母集団として扱い、n で割ります。記号は σ(シグマ)です。一方、5日分のデータから路線Aが普段どんな運行なのかを推測したいなら、5日分はもっと多くの日の中から取り出した標本なので、n−1 で割ります。記号は s です。
この n−1 で割る方法がベッセルの補正です。標本の偏差は、標本自身の平均からの距離で測ります。標本平均はそのデータの真ん中に位置するので、本当の(未知の)平均から測った偏差よりも小さく出てしまいます。したがって n で割ると、分散は平均して (n−1)/n 倍に過小評価され、n−1 で割ればこの偏りが消えます。なお、偏差の合計は必ず0なので、自由に決められる偏差は n−1 個だけ、という見方(自由度)もあります。
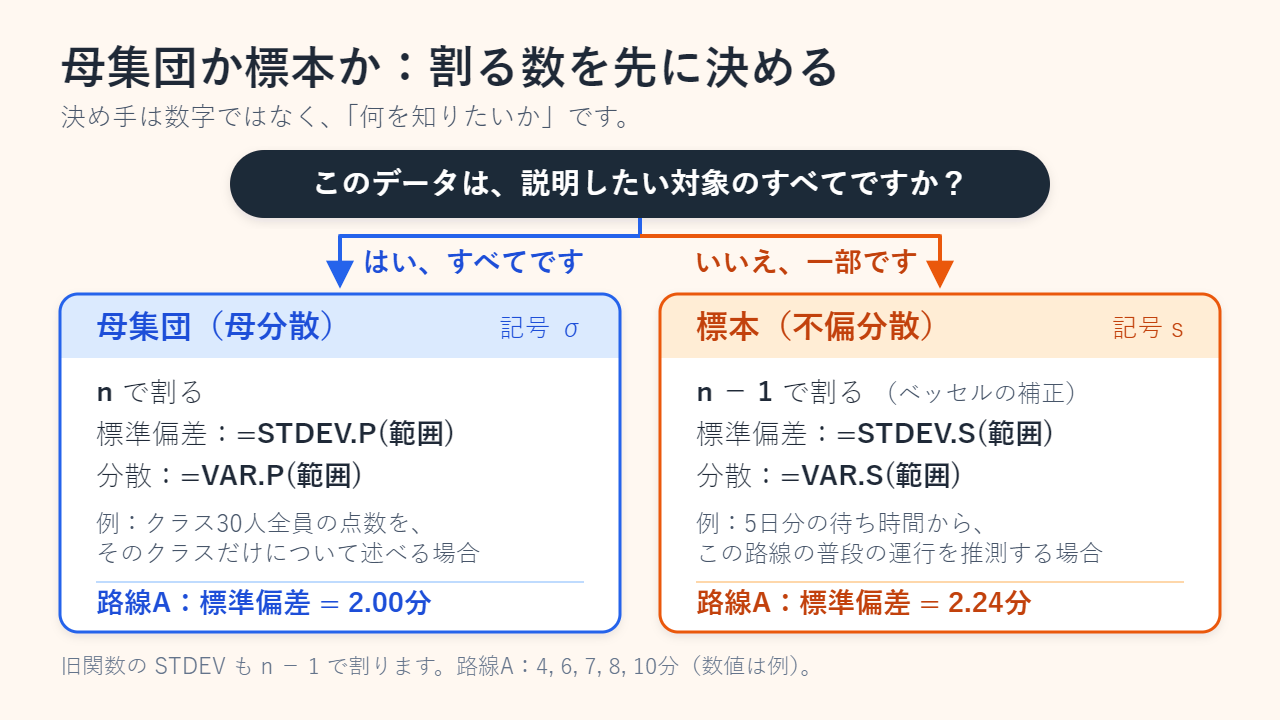
| 項目 | 母集団(n で割る) | 標本(n−1 で割る) |
|---|---|---|
| 偏差平方和を割る数 | n | n−1 |
| 分散の呼び方 | 母分散 | 不偏分散 |
| よく使う記号 | σ | s |
| Excel の標準偏差の関数 | STDEV.P | STDEV.S(旧関数は STDEV) |
| Excel の分散の関数 | VAR.P | VAR.S |
| 路線Aの標準偏差 | 2.00分 | 2.24分 |
表の「分散の呼び方」には注意が必要です。日本語の教科書や解説では、n で割った分散を「標本分散」、n−1 で割った分散を「不偏分散」と呼び分けることがよくあります。一方、Excel の関数名では n−1 で割るほうに「S(標本)」が付きます。同じ「標本」でも指す式が資料によって違うので、名前より「n で割るのか、n−1 で割るのか」で確認するのが確実です。この記事では、n で割るほうを母分散、n−1 で割るほうを不偏分散とし、不偏分散の平方根を標本標準偏差と呼びます。
Excel(エクセル)で確かめる手順です。関数名は日本語版でも英語のままです。
- セル A2:A6 に待ち時間 4、6、7、8、10 を入力します。
- 空いているセルに
=STDEV.P(A2:A6)と入力して Enter を押すと、2 が表示されます。 - 別のセルに
=STDEV.S(A2:A6)と入力すると、約 2.236 が表示されます。
Microsoft の説明では、どちらの関数もセル範囲内の空白セル・文字列・論理値を無視します。文字列として入力された数字は、エラーも出ずに計算から外れるので注意してください。
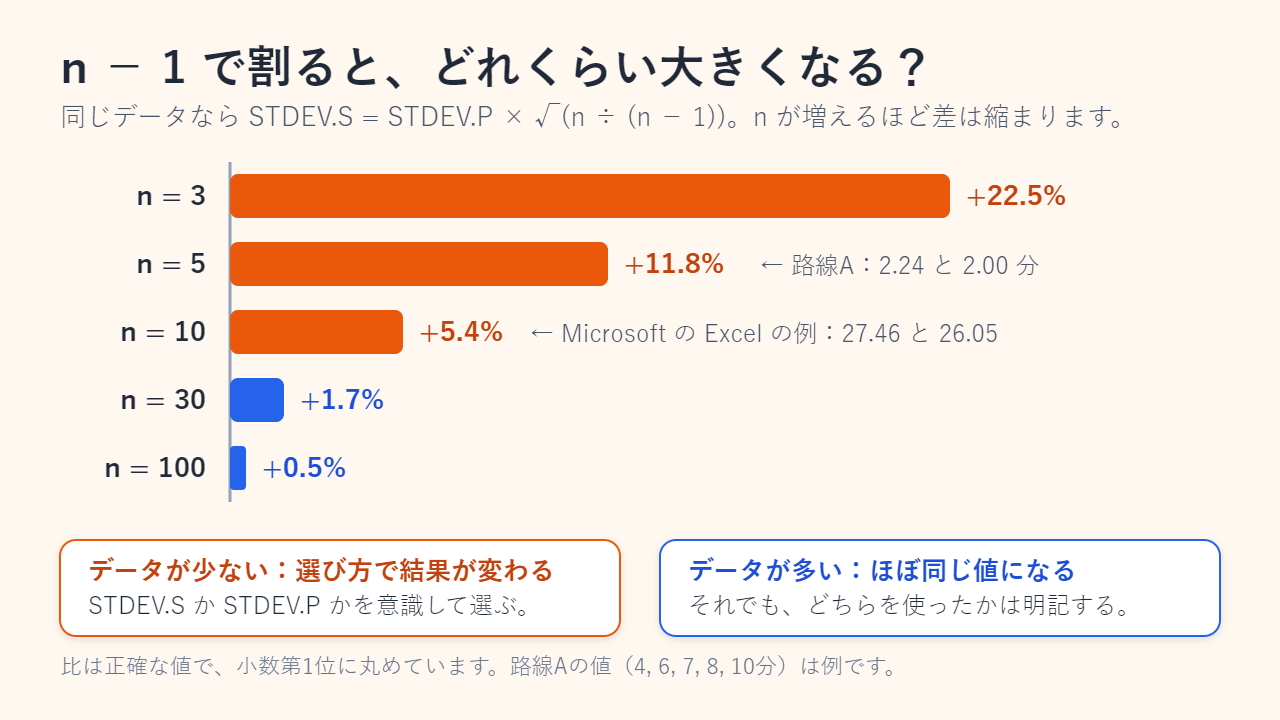
割り方の違いで、結果はどれくらい変わる?
同じデータなら、n−1 で割った標準偏差は、n で割った標準偏差の √(n ÷ (n−1)) 倍になります。割合にすると、n = 3 で 22.5%、n = 5 で 11.8%、n = 10 で 5.4%、n = 30 で 1.7%、n = 100 ではわずか 0.5% 大きくなります。Microsoft の公式ページにある強度データ10個の例が n = 10 のケースで、STDEV.S は 27.46、STDEV.P は 26.05 を返します。
標準偏差の読み方:平均や単位とセットで見る
標準偏差は、必ず平均や単位とセットで読みます。平均7分に対する標準偏差2分は大きなばらつきですが、60分の通勤時間に対する2分ならごくわずかです。標準偏差を平均で割った「変動係数」を使うと、この違いを数字で比べられます。路線Aは 2 ÷ 7 ≈ 29%、路線Bは 4 ÷ 7 ≈ 57% です。
データが左右対称の釣り鐘型(正規分布)に近いときは、標準偏差からデータが入る範囲の目安もわかります。NIST によると、正規分布では、平均から ±1 標準偏差の範囲に 68.27%、±2 標準偏差の範囲に 95.45%、±3 標準偏差の範囲に 99.73% が入ります。たとえば、釣り鐘型に近いテストの得点で平均70点・標準偏差10点(例として作った数値)なら、約3分の2の人が60点から80点の間に入ります。この目安は、所得や待ち時間のように右へ長く裾を引く偏った分布には当てはまりません。
日本で身近な「偏差値」も標準偏差から作られます。50 + 10 × (得点 − 平均点) ÷ 標準偏差 で求めるので、上の例で80点なら偏差値は60です。
よくある間違い
- 少ない標本に STDEV.P を使う。散らばりが小さく出てしまいます。n = 5 なら、STDEV.S のほうが 11.8% 大きくなります。
- 分散を標準偏差として報告する。分散 4 分² の標準偏差は2分であり、4分ではありません。
- 外れ値を見落とす。偏差を2乗するため、極端な値が1つあるだけで結果が大きく左右されます。路線Aの10分を20分に変えると、n で割った標準偏差は2分から約5.66分に跳ね上がります。
- 68–95–99.7 の目安を偏った分布に使う。先にヒストグラムで形を確認しましょう。
- 標準偏差と標準誤差を混同する。平均の標準誤差 s ÷ √n は、平均値がどれくらい正確にわかるかを表すもので、個々のデータの散らばりではありません。路線Aでは 2.24 ÷ √5 ≈ 1.0分です。
よくある質問
標準偏差がマイナスになることはありますか?
ありません。2乗の平均の平方根なので、最小値は0です。0になるのは、すべてのデータがまったく同じ値のときだけです。
標準偏差と平均偏差は同じですか?
違います。平均偏差(平均絶対偏差)は距離そのものの平均で、標準偏差は距離を2乗して平均し、平方根をとったものです。路線Aではそれぞれ1.6分と2分になります。
クラスのテストの点数には、どちらを使えばよいですか?
そのクラスだけを説明したいなら STDEV.P、クラスを生徒全般の標本として扱うなら STDEV.S を使います。
Excel の STDEV と STDEV.S は違うのですか?
どちらも標本として n−1 で割る関数で、結果は同じです。STDEV は旧関数で、STDEV.S に置き換えられましたが、互換性のために残されています。
参考資料:NIST e-Handbook「Measures of Scale(散らばりの尺度)」(英語)、NIST e-Handbook「“正規”データとは何か」(英語)、Microsoft サポート「STDEV.S 関数」、Microsoft サポート「STDEV.P 関数」
関連記事
本文の理解を助けるために制作したオリジナルイラストです。