世論調査の数字を読む:標本数・標本誤差・信頼区間を確認
この記事はAIの支援を受けて原文を翻訳したものです。専門用語や数式は原文とあわせて確認してください。
調査結果で賛成52%、反対48%を見ると、差が明確だと感じる場合があります。しかし標本誤差±3パーセントポイント、信頼水準95%という説明が付くと、どう読むべきでしょうか。数字の大きさだけでなく、調査対象、標本の抽出方法、比較する項目を併せて見る必要があります。この記事は実際の選挙や特定の政策の結果を予測せず、ニュースの調査数値を読むために必要な標本・誤差・区間の基本的な区別を、架空の事例で説明します。
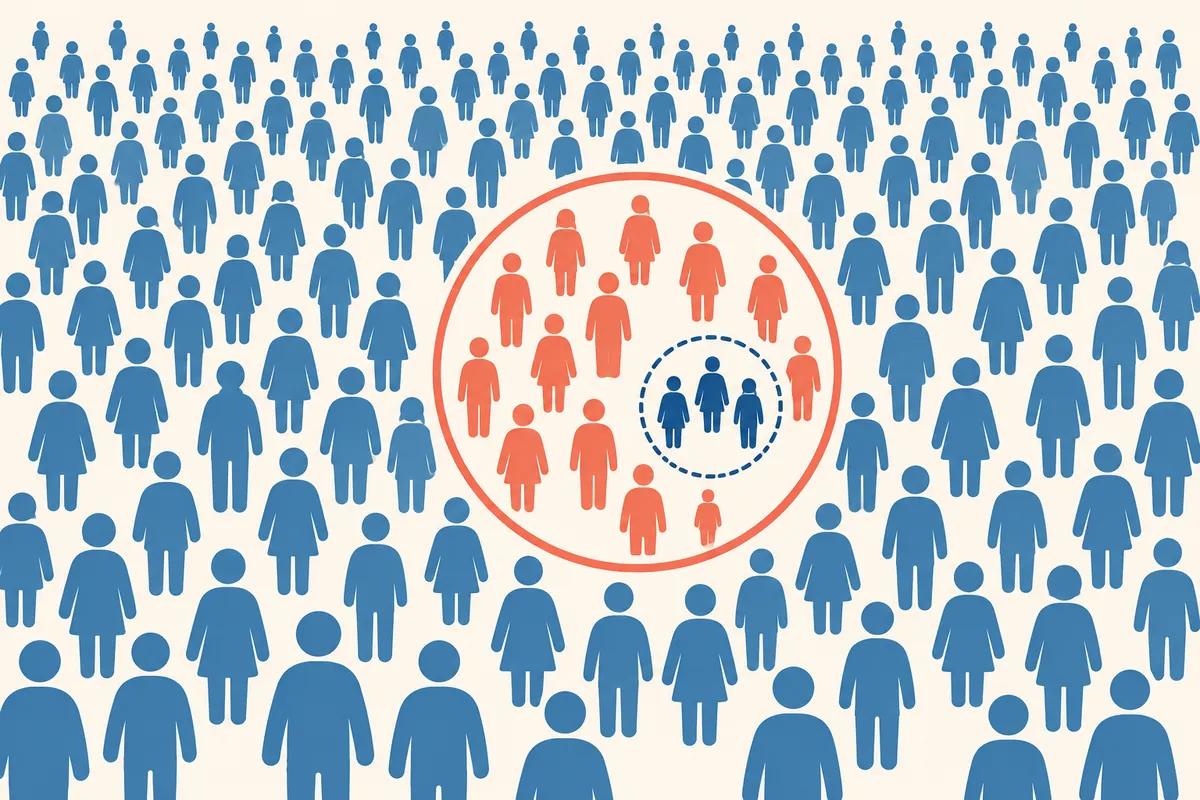
1. 最初に「誰の意見か」を確認する
全国の成人、特定都市の住民、サービス加入者、オンライン掲示板の参加者は、異なる調査対象です。見出しが「国民の考え」と記していても、本文の回答者は特定アプリのユーザーかもしれません。標本数が多いだけで対象が自動的に全国民になるわけではありません。母集団は結論を述べたい集団全体、標本は実際に調査した一部です。
AAPORの公開基準は、調査対象、募集方法、質問、時期、標本数、重み付けなどの方法情報の公開を説明しています。読者が適用する際は見出しを先に判断するより、調査原文で対象と募集方法を1行ずつ探すとよいでしょう。以下の比較表と記載形式は、この記事で構成した読解の道具です。
2. 記事で探す項目と理由
| 項目 | 確認する問い | 見落とした場合の誤解 |
| 対象集団 | 誰に一般化したいか | 加入者の意見を全住民の意見として読む |
| 標本数 | この数値に実際に何人が含まれるか | 全体人数を小集団にも適用する |
| 募集方式 | 確率標本か自発的参加か | すべての調査に同じ誤差公式を使う |
| 質問・回答選択肢 | 正確に何を尋ねたか | 似た表現の異なる質問を同一視する |
| 調査時期 | どの出来事の前後で調査したか | 異なる時点の数値を直接比較する |
| 誤差・重み付け | 何を含めた精度か | 標本誤差を全誤りの保証として読む |
回答率も資料にあれば確認しますが、低い・高いという1つの数字で品質を自動判定しません。どの集団が回答から抜け、どう対応したかが必要です。同じ機関の反復調査でも、質問や募集方式が変われば比較条件が変わる場合があります。
3. 標本誤差は調査のすべての誤りの合計ではない
同様の方法で標本を取り直すと、推定値は少しずつ変わります。標本誤差はこうした標本抽出の変動に関係します。質問が一方の答えに誘導したり、特定の人が調査に入りにくかったりする問題まで、±3という1つの数字ですべて解決するわけではありません。Pew Research Centerの標本誤差ガイドも、重み付け、非標本誤差、小集団や比較の不確実性を区別しています。
例えば図書館の満足度を調べる際に館内の利用者だけを対象にすると、長く利用していない住民の不満を見落とすかもしれません。標本を増やしても、こうした選択の違いが自動的に消えるわけではありません。そのため「人数が多い」と「対象集団を適切に代表する」は別の問いです。この図書館の事例は実際の調査結果ではなく、説明用の設定です。
4. 95%信頼水準を読む正確な視点
頻度論の信頼区間における95%は、同じ条件で標本抽出と区間計算を繰り返すとき、その方法で作った区間が真値を含む割合の説明です。計算済みの1つの区間に対して「真値がこの中に入る確率は正確に95%」と単純に言い換えることとは異なります。モデルと標本抽出の仮定も必要です。
読者が記事で行うことは、すべての統計を計算し直すことではありません。まず信頼水準と区間が記されているか、それが全標本の比率か、特定の下位集団のものかを確認します。区間が広いと推定の精密さが低いと読めますが、区間だけで調査設計の妥当性すべてを評価できません。
「95%だから調査は95%正確」という表現も避けるべきです。正確さの基準が明示されていないからです。質問が適切に測定したか、回答しなかった人の傾向は何か、実際の結果と比較する条件は合うかは、別の検討事項です。信頼水準を見つけたら、数字を保証書として読まず、計算方法の条件を探してください。
5. 標本数と誤差を架空の数字で計算する
単純無作為標本で回答は独立し、母集団が十分に大きい状況を仮定します。比率pの標準誤差をおよそ√[p(1-p)/n]とし、95%近似誤差幅を1.96倍で計算できます。実際の調査では複雑な標本抽出、重み付け、標本サイズ、極端な比率などを考慮する必要があるため、これは記事の概念を学ぶ例です。
p=0.5、n=1,000なら、√(0.25/1,000)=約0.01581で、1.96を掛けると約0.03099です。百分率では約±3.10パーセントポイントです。nを4,000に増やすと約±1.55パーセントポイントに減ります。この条件では標本を4倍にして初めて誤差幅が半分になります。人数を2倍にしても、誤差が半分になるわけではありません。
p=0.52を同じ単純条件に入れると、近似区間は約48.90%から55.10%になります。ここでは52%に±3%を相対比率として掛けるのではなく、パーセントポイントを足し引きする区別が必要です。実際の記事に区間が示されていれば、任意の公式より、その調査の報告区間と計算基準を先に読みます。上の数字は実際の世論データではありません。
6. 全体標本と小集団の標本は異なる
回答者全体が1,000人でも、特定の年齢層の回答者は100人かもしれません。全体の誤差幅をその年齢層にそのまま付けると、精密さを過大に示す場合があります。同じ単純仮定でp=0.5、n=100なら、95%近似誤差幅は±9.8パーセントポイントです。調査原文で小集団の標本数と区間を別途探してください。
架空の図書館調査で全体の満足度60%、ある小集団の満足度70%なら、差は10パーセントポイントです。しかし小集団の規模と設計が違う場合、数字だけでその集団が確実により満足しているとは結論できません。比較目的に合う分析と不確実性が必要です。全体標本数、小集団標本数、報告された誤差基準を分けて1行に記すと、混同を減らせます。
7. 2項目の差と2時点の変化も別々に見る
賛成52%、反対48%は4パーセントポイントの差ですが、1つの比率の誤差幅を差の誤差幅として使ってはいけません。同じ人から出た2つの回答比率は関係している場合があります。2時点の調査の差も、標本が独立か同じ人を繰り返し調査したかで計算が変わります。「2区間が重なる」という観察だけですべての差の検定に代えることもできません。
読者の実用的な次の行動は比較条件の確認です。質問、回答選択肢、対象、募集方式、重み付け、時期を並べて記します。条件が異なるのに片方の数字が少し高いだけで、確定的な変化と解釈しないでください。報告書が差の検定や傾向分析を提供するなら、その結果と限界を一緒に読みます。比較分析がなければ、「表示数値に差はあるが、変化の不確実性は別途確認が必要」と記録できます。
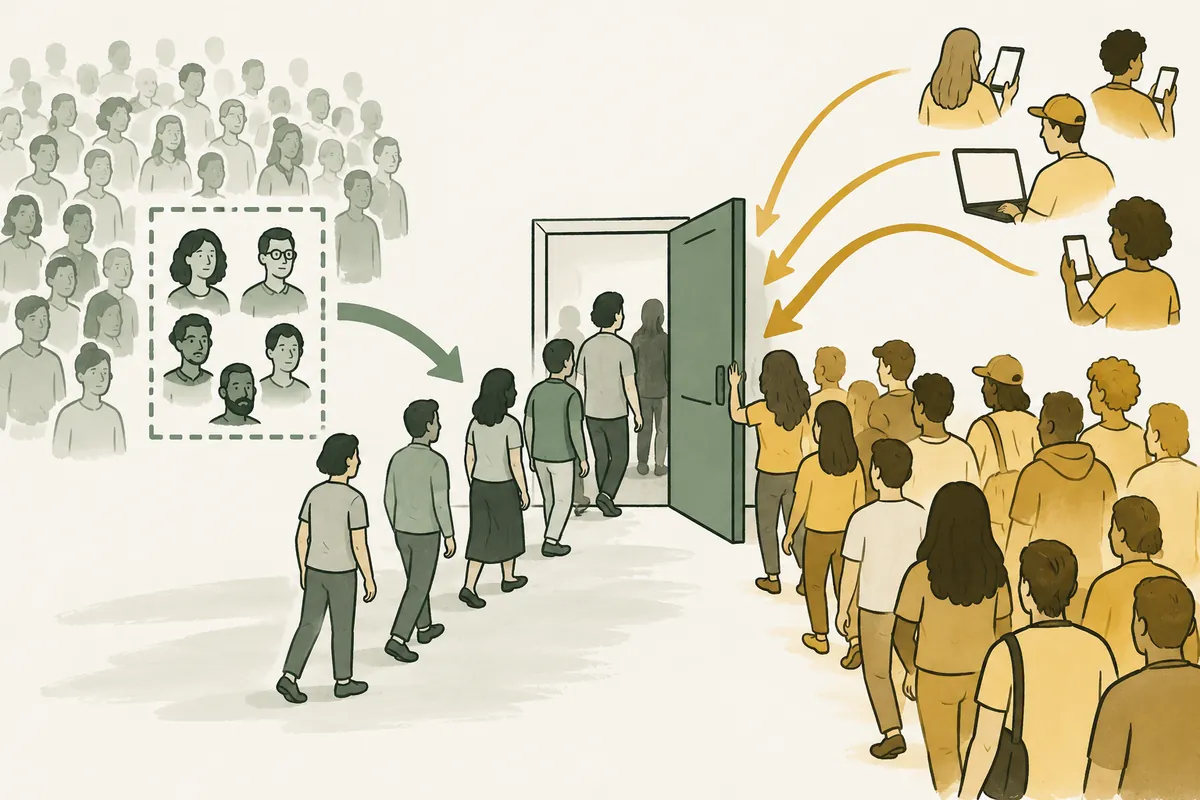
8. オンライン投票と確率標本調査を区別する
リンクを押した人が自発的に参加する投票は、有用な意見を示す場合があります。ただし参加者集団と全利用者を同じと想定してはいけません。AAPORの調査方法ガイドは、オンライン方式にも確率標本と非確率標本があると説明しています。オンラインという伝達方式だけで調査設計を確定しません。
単純無作為標本の公式に自発的参加者数だけを入れ、もっともらしい±値を付けるのは適切でない場合があります。非確率調査で精度の数値を示すなら、どのモデルと仮定で計算したかを確認する必要があります。方法の説明がなければ参加者の回答分布に限定して読むのが正確です。「500人がクリックした」事実と「全住民の考えをこの誤差で推定した」主張は異なります。
9. 記事1本を読んだ後に残すメモ
1枚に調査機関と依頼機関、調査日、対象集団、標本数、募集方式、原文の質問、数値、報告区間を記します。見つからない項目は空欄に「未確認」と示してください。情報がないことを望む仮定で埋めません。重み付けや設計効果の説明は別の方法付録にある場合があるため、記事にリンクされた報告書も確認します。
最後の文は結果と解釈を分けます。例えば「この調査の回答者の表示満足度は60%で、全住民への解釈には募集方式と区間をさらに確認する必要がある」と書けます。これは結果を無視する態度ではなく、資料の述べる範囲を保持する方法です。標本の大きさだけでなく、誰がどう含まれたかを併せて見ると、より正確な読者になれます。
10. 最後にパーセントとパーセントポイントを確認する
架空の満足度が40%から44%に変わったなら、差は4パーセントポイント、初めの値に対する相対増加は4/40×100=10%です。2つは同じ変化の異なる基準なので、記事が何を述べるか確認します。原文の質問が同じか、比較可能な調査かを確認することは、この計算とは別です。相対増加を計算できるだけで、実際の変化が確実とは結論しません。
公式出典と執筆基準
資料確認日:2026-10-09。実際に開いた公式資料をもとにAIが作成した説明です。別途示した計算・コード・確認事例は説明用であり、ユーザー環境を直接試験した結果や実測結果ではありません。公開日には機能と資料の変更の有無を再確認します。
本文の理解を助けるために制作したオリジナルイラストです。
Tistoryの原文 ↗