平均数与中位数的区别:偏斜数据中应读取的数字
本文在AI辅助下由原文翻译而成。请结合原文核对专业术语和公式。
平均数与中位数计算器
输入仅在此页面处理,不会发送到服务器或保存。直接计算平均数与中位数
用逗号或空格分隔输入数字。最多500个,每个数字绝对值不超过1万亿。请比较单位相同的值。输入仅在当前页面计算。
说明示例的平均数为100,中位数为30。此计算不能确认样本代表性或资料准确性。
JavaScript已关闭。公式:平均数=总和÷个数,中位数=按大小排序后的中间值(偶数个时为中间两个值的平均)。
平均数与中位数回答不同问题
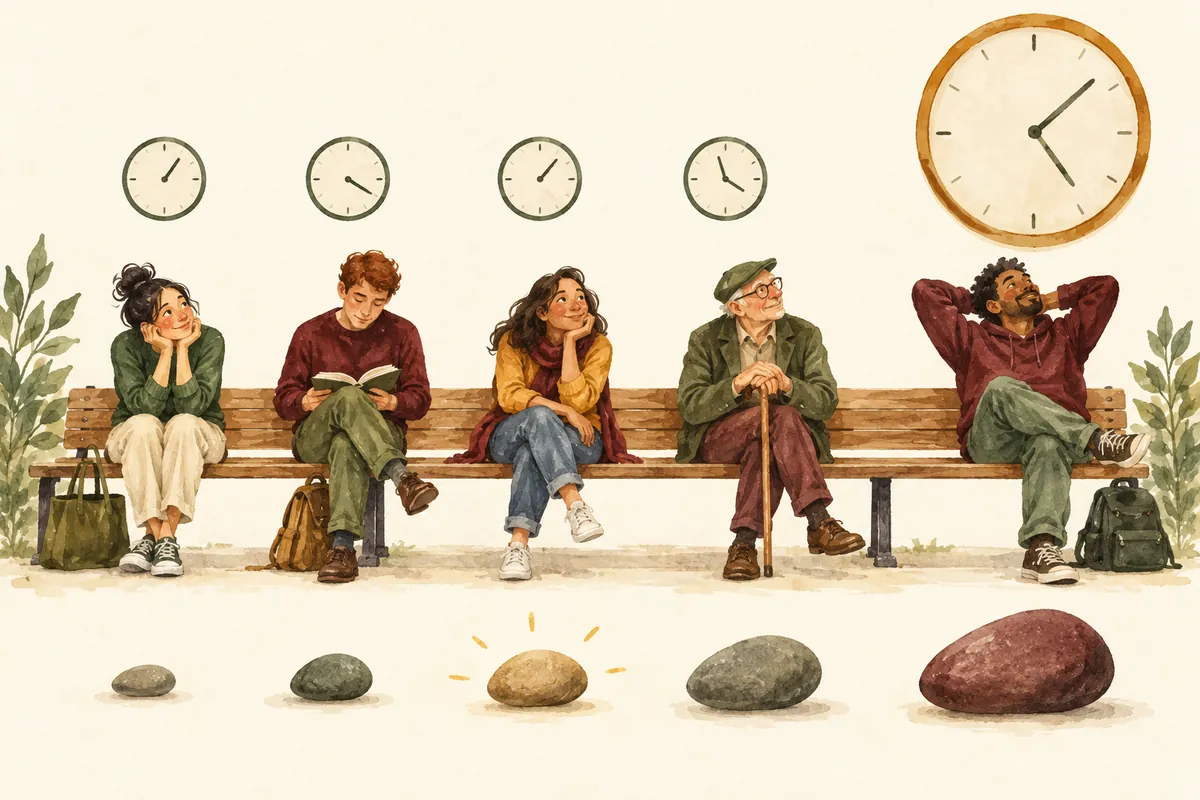
看到“平均等待时间10分钟”的提示,容易认为多数人等了约10分钟。但只要少数人等很久,平均数也会增大。中位数是按大小排序后,以中间位置为基准读取的数值。比起无条件认为某个值更准确,应先区分想知道整体负担,还是一般人的体验。
本文使用虚构等待时间资料。数值是说明用示例,并非任何机构实际统计或实测结果。通过五个简单值跟随计算,同时查看只合并平均数造成的错误与缺失处理的影响。参考NIST与澳大利亚统计局官方说明,以下情境与计算示例则重新构建,以帮助读者判断。
确认平均数与中位数前,资料单位与对象应相同。客户各自等待时间,还是各窗口每日平均;秒还是分钟;是否包含无需等待的人,都会影响数字。即使代表值计算正确,问题与资料范围不同,也可能让读者误解。
1. 用相同五人的资料直接计算
假设说明用等待时间为2、3、4、5、36分钟。总和50分钟,除以五人,平均为10分钟。已按大小排序,因此第三个值4分钟为中位数。平均10分钟与中位4分钟来自相同资料,并非其中一个计算错误。
为比较,将最后一个值改为6分钟,得到2、3、4、5、6分钟。总和20分钟,平均4分钟,中位数也为4分钟。两组资料中间顺序的值相同,但总等待时间不同。这说明平均数与中位数提取不同信息,也能直接看到极端改变一个值时,平均数如何显著变化。
| 虚构资料/分钟 | 平均数 | 中位数 |
| 2, 3, 4, 5, 6 | 20 ÷ 5 = 4分钟 | 4分钟 |
| 2, 3, 4, 5, 36 | 50 ÷ 5 = 10分钟 | 4分钟 |
| 2, 3, 5, 6 | 16 ÷ 4 = 4分钟 | (3 + 5) ÷ 2 = 4分钟 |
2. 中位数不必是实际观测值
奇数个资料取中间一个值,偶数个则用中间两值平均。上述四个值2、3、5、6分钟,中间为3和5,因此中位数4分钟。即使没人实际等4分钟,中位数仍可能为4分钟。“必然有一个人等于中位数”的解释不正确。
忘记排序,会读错中间位置。如果输入顺序为36、2、5、3、4分钟,不能选第三个输入值5分钟为中位数。必须按大小排序后找中间。若表格不便改变行序,可保留原始行ID,排序计算副本。报告中也记录是否保留原顺序,避免与其他列的关联中断。
还应区分可以排序,与算术计算有意义。颜色等无大小顺序类别,难以赋予平均数或中位数。满意度等级等资料中,顺序含义与等级间隔含义可能不同。不能因用数字编码,就假设可立即像时间或长度一样相加相除。
3. 需要平均数与需要中位数的问题
想知道全部等待时间总和时,人数与平均数的关系很有用。虚构五人案例,平均10分钟乘以5人,得到总共50分钟。比较哪个窗口累计延迟较大时,可一起查看这种总量。但各人重叠等待时间之和,可能不等于窗口停止的实际经过时间,因此应写明指标含义。
想说明代表性一个人的体验时,同时提供中位数有帮助。示例中中位4分钟,表示中间位置的等待时间。但这个值不能说明有多少人等得很久。仅把平均改写为中位,不能认为已充分解释等待问题。
实用报告可写为“五人平均10分钟、中位4分钟、最小2分钟、最大36分钟”,同时提供对象数与范围。样本仅五人也很重要。一人的特殊情境可能显著改变整体结果,因此不声称这些数值预测了次日所有使用者的等待时间。
4. 不因数值较大就立即删除
36分钟比其他值大,自动删除可能隐藏真实长等待体验。先确认是输入错误还是实际事件。可以调查是否分钟列输入秒值、等待起始时间输入错误,或特定流程造成长等待。确认错误则留下修改原因;实际观测则按分析目的判断是否包含。
若资料包含正常的长等待,应同时显示平均与中位,说明差异原因。反之,确认是笔误的值,应关联保存原值与修改值。不能仅因未得到所需结果就排除大值。若需要排除前后数值,可并列提供两种结果与排除标准。
NIST位置代表值说明讨论偏斜或长尾情况下,平均数与中位数反应可能不同。不能把它作为“所有右偏小数据,平均必定大于中位”的判定规则。应一起检查实际值与分布,不宜只看差异方向就确定整体数据形状。
5. 合并多组平均时检查人数
假设虚构A窗口两名用户平均等10分钟,B窗口八名用户平均等20分钟。直接把两个窗口平均相加除以2,得到15分钟。但计算全部十人的平均,必须反映各窗口人数不同。A总和20分钟与B总和160分钟合计,除以十人,得到18分钟。
这里15分钟是给两个窗口平均相同权重所得,18分钟是给每名用户相同权重的整体平均。它们回答不同问题。未写明数值目的,可能误认为其中一个计算错误。若报告讨论整体用户体验,应检查以各组人数作为权重的计算。
也不能将两个组中位数平均,得到整体中位数,因为中位数需知道全部资料中间顺序在哪里。只收到组代表值,可能信息不足以计算整体中位。此时应说明为什么需要原始数据或分布信息,不要随意估计未知值。
6. 空白与0会改变分母
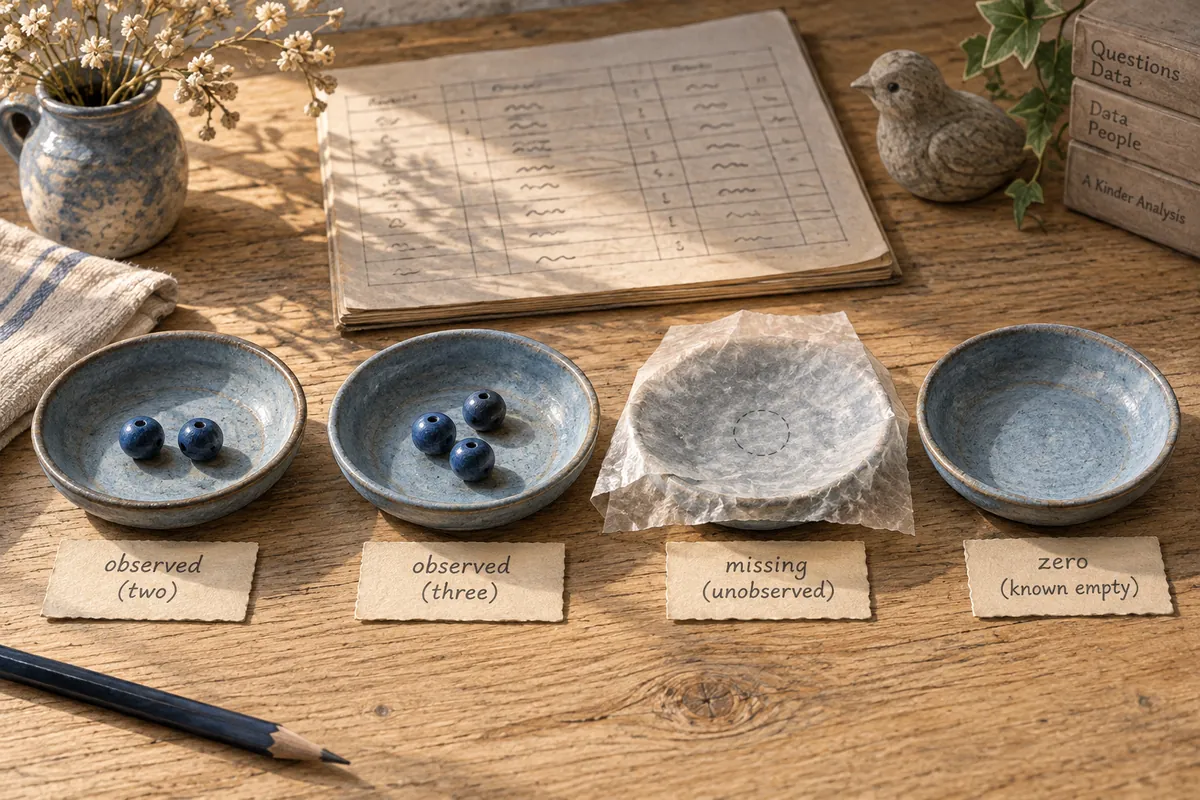
考虑说明资料2、3、空白。若空白视为未观测值,两个已知值平均为2.5。若把空白变为实际0,三个值平均约1.67。表看似相同,计算含义不同。必须区分无需等待者的0与未测量者的空白。
报告中写明分母和缺失数,如“有效观测两项、缺失一项”。原对象三人,不代表平均分母总为3。反之,把有效等待0观测当空白排除,也会改变代表值。计算前确认各编码含义,并记录整理阶段如何处理缺失。
混合单位也造成类似问题。一行120秒、另一行3分钟,若只存数字120与3,不能直接平均。先转为同一单位并保留原单位。小数位数在最后显示阶段确定,同时确认中间舍入是否改变结果。
7. 结合图形与数字阅读的方法
五个说明值可表示为横轴为分钟的点图。2、3、4、5附近有四点,36处有一个远离的点。一起标注平均10分钟与中位4分钟,容易理解两种代表值差异。制作实际统计图时,同时标明轴单位、样本数与资料来源。
比较大量资料时,除代表值外,分布与组构成也重要。如果上午短业务多,下午长业务多,时段平均差异未必只表示窗口性能差异。先确认包含哪些用户与测量标准是否相同。越合并数字,越需要重新阅读原资料条件。
小表最大最小值易于计算,但说明常见体验有局限。若图因一个点而大幅延伸,短等待区间差异也可能不清楚。截轴显示时,应明确范围与显示方式,不将大值隐藏在画面之外。可视化目的是让人读取分布,而非使代表值显得有利。
8. 检查统计句子的最后问题
先确认数字是谁的什么资料、单位是什么、有多少有效值、如何处理缺失与排除。然后读取平均与中位回答什么问题;合并多个组时,确认权重。最后查看是否有分布或范围信息,能看到代表值背后的差异。
读者自行撰写报告时,可在句中加入条件,如“说明用五项资料平均10分钟、中位4分钟,包含一项长等待”。比“通常等10分钟”更明确说明计算了什么。同时提供表格与说明,可以让读取两个代表值的人作必要判断。
平均与中位差异,不只是记忆统计术语,也是确认从什么视角概括资料的工具。理解同一资料的总量与中间体验可能呈现不同结果,能更准确阅读新闻、工作报告与服务说明数字。实际决策应先检查原始资料范围与条件,而非直接套用示例计算。
官方来源与撰写标准
资料确认日期:2026-10-03。这是AI依据实际打开的官方资料撰写的说明。单独标注的计算、代码与检查案例用于说明,并非直接测试用户环境或实测结果。发布时重新确认功能与资料是否改变。
为帮助理解本文而制作的原创插画。
Tistory 原文 ↗