各组都更好,整体却更差?用一个例子读懂辛普森悖论
本文在AI辅助下由原文翻译而成。请结合原文核对专业术语和公式。
简单任务和困难任务中,方法B都表现更好,整体成功率却可能是A更高吗?如果两者尝试的任务构成不同,就可能出现这种反转。理解这一点,能帮助我们在用汇总百分比排名前,先检查它合并了什么。
一个可以自己算的虚构例子
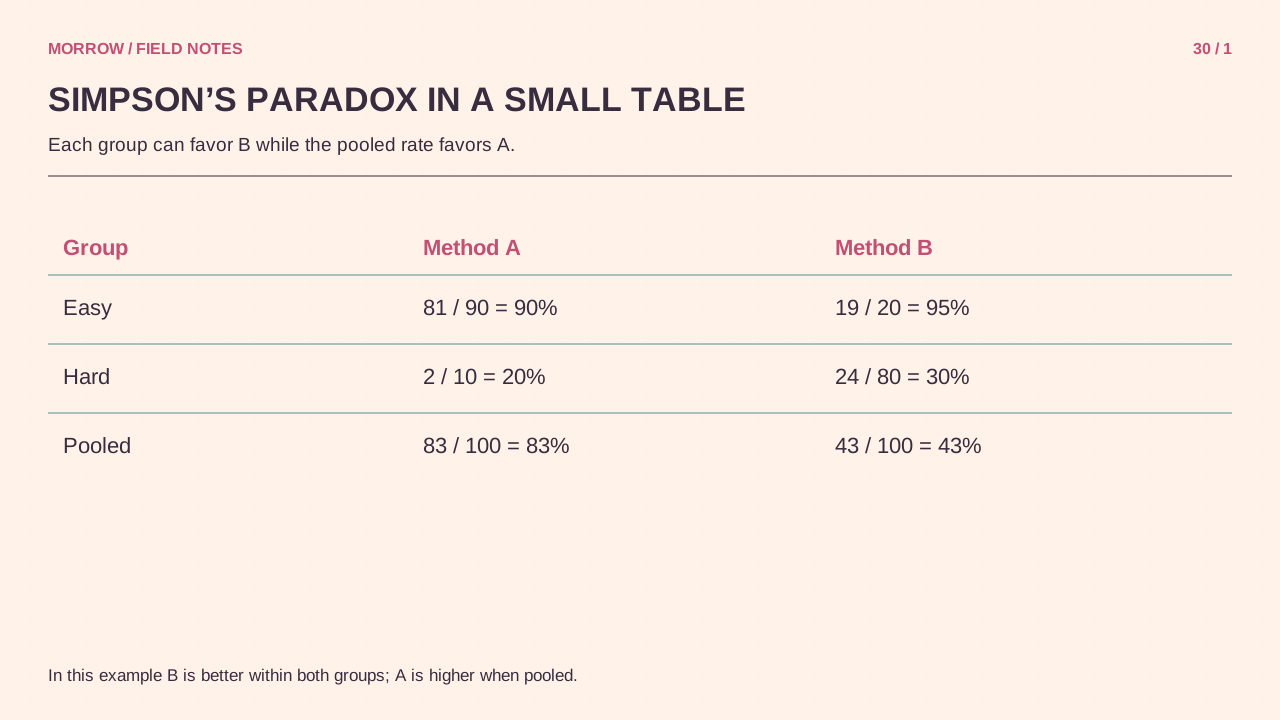
以下数据用于教学,不是真实产品或试验结果。A主要尝试简单任务,B主要尝试困难任务。
| 任务 | A成功/总数 | A成功率 | B成功/总数 | B成功率 |
|---|---|---|---|---|
| 简单 | 81/90 | 90% | 19/20 | 95% |
| 困难 | 2/10 | 20% | 24/80 | 30% |
| 合计 | 83/100 | 83% | 43/100 | 43% |
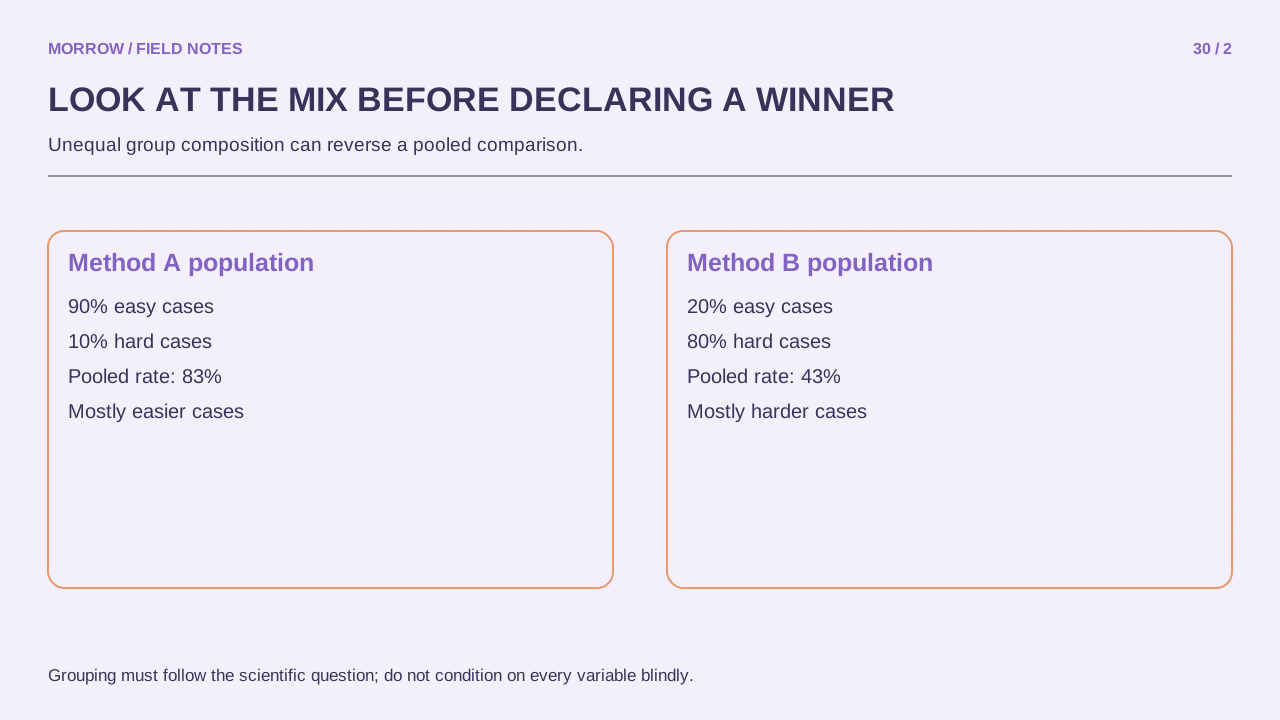
简单任务中B的95%高于A的90%,困难任务中B的30%高于A的20%。但A的任务中90%是简单任务,B只有20%。整体83%与43%反映的是不同任务混合,合计计算本身并没有错误。
隐藏权重不同
A的整体率为0.9 × 90% + 0.1 × 20% = 83%;B为0.2 × 95% + 0.8 × 30% = 43%。各组比例用了不同权重,所以组内排名不必在汇总后保持。Simpson的1951年原始论文讨论了列联表解释问题,BMJ关于混杂与辛普森悖论的说明展示了第三因素相关的反转。
观察到的整体率回答“实际尝试的全部任务成功了多少”;分组比较回答“同一种任务里谁的成功率更高”。这是两个不同问题。先决定想知道什么,数字就不再像互相矛盾。
明确用同一构成比较
作为演示,把简单、困难任务各占50%。A为(90% + 20%) ÷ 2 = 55%,B为(95% + 30%) ÷ 2 = 62.5%。这是统一假设构成后的比较,不是原数据实际总比例。真实决策中,任意选择50%并不一定合理,应按目标群体或预计任务构成说明权重依据。
分组不自动等于真相
应该按什么变量分组,取决于问题和数据产生过程。按结果发生后的变量,或受选择过程影响的条件分组,可能引入另一种偏差。这张表不能证明B在所有条件下都具有因果优势。分配方式、时期、对象差异和未测因素也可能重要。
- 同时查看汇总比例的分子、分母。
- 检查相关前置条件的构成差异。
- 展示分组表和样本数量。
- 使用统一构成时解释权重。
- 区分观察关联与因果主张。
重点不是抛弃整体数字,而是理解它把哪些条件合在一起。知道“整体A更好、每组B更好”可以同时成立,才能在接受简单排名前,先问比较的问题和分母是什么。
相关实用文章
为帮助理解本文而制作的原创插画。