전체 성공률과 그룹별 결과가 뒤집히는 이유: 심슨의 역설
두 방법을 쉬운 문제와 어려운 문제에서 각각 비교했더니 B가 모두 더 좋았습니다. 그런데 전체 성공률은 A가 더 높게 나올 수 있을까요? 문제 유형의 구성 비율이 다르면 가능합니다. 이를 이해하면 대시보드의 전체 비율 하나만 보고 성과를 판단하기 전에 무엇을 확인해야 하는지 알 수 있습니다.
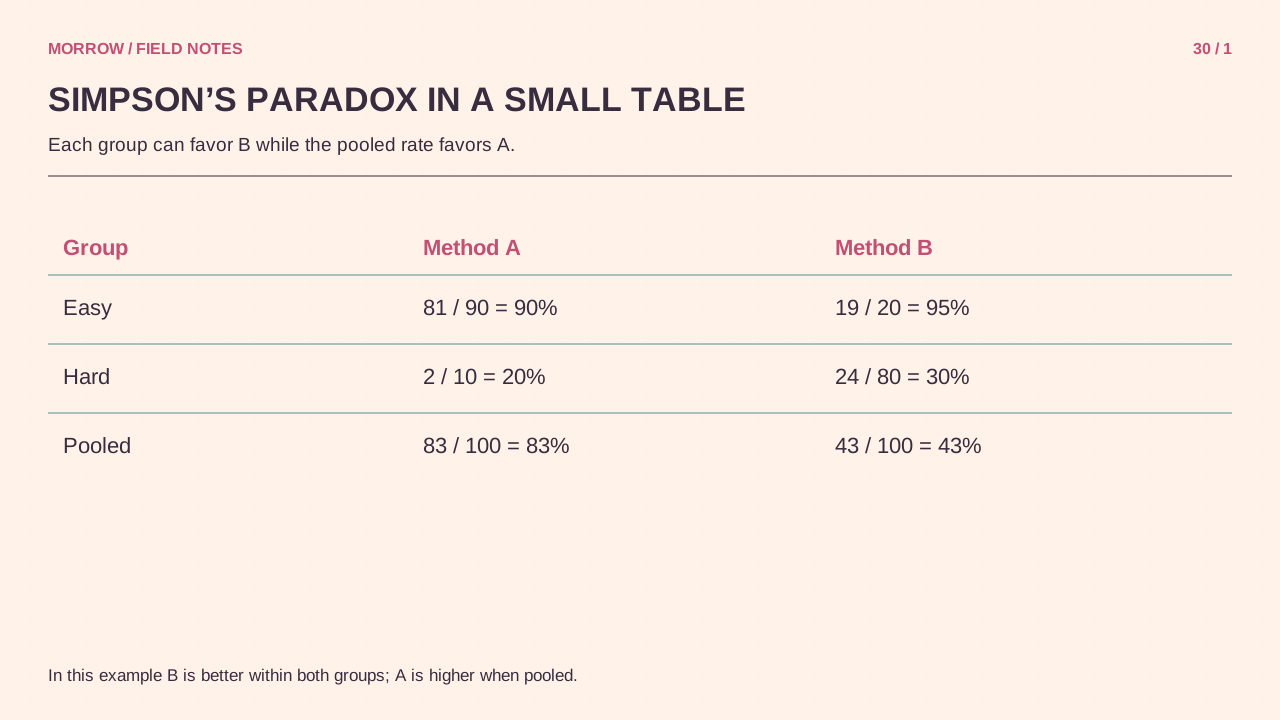
직접 계산할 수 있는 가상 예제
아래 수치는 설명을 위해 만든 자료이며 실제 제품이나 시험 결과가 아닙니다. A는 쉬운 문제를 많이, B는 어려운 문제를 많이 풀었습니다.
| 문제 유형 | A 성공/전체 | A 성공률 | B 성공/전체 | B 성공률 |
|---|---|---|---|---|
| 쉬움 | 81/90 | 90% | 19/20 | 95% |
| 어려움 | 2/10 | 20% | 24/80 | 30% |
| 전체 | 83/100 | 83% | 43/100 | 43% |
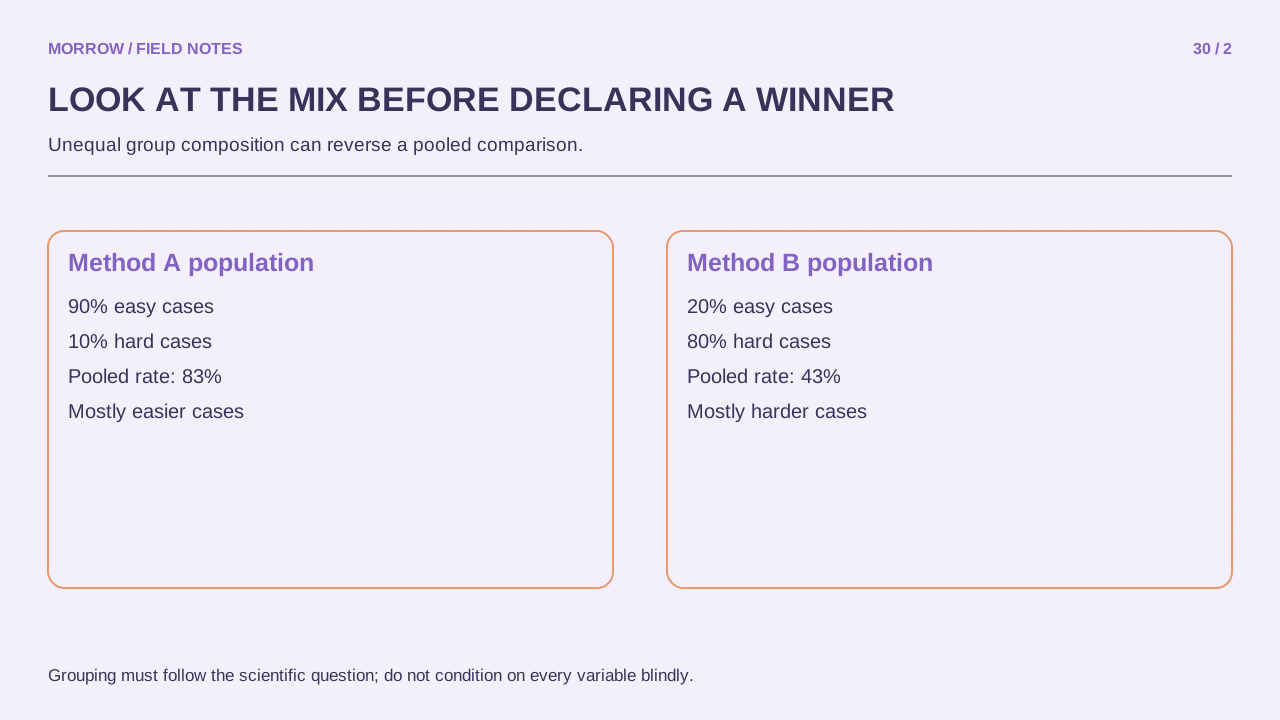
쉬운 문제에서 B는 95%로 A의 90%보다 높습니다. 어려운 문제에서도 B는 30%로 A의 20%보다 높습니다. 하지만 A는 쉬운 문제 비중이 90%, B는 20%입니다. 전체의 83%와 43%는 서로 다른 문제 구성을 반영합니다. 전체 합계를 계산하는 데 오류가 있는 것이 아닙니다.
평균에 숨은 가중치가 다르다
A의 전체 비율은 0.9 × 90% + 0.1 × 20% = 83%입니다. B는 0.2 × 95% + 0.8 × 30% = 43%입니다. 두 방법의 비율에 같은 가중치를 주지 않았으므로, 그룹별 순서가 전체에서도 유지되어야 할 이유가 없습니다. Simpson의 1951년 논문은 분할표에서의 해석 문제를 다룹니다. BMJ의 교란과 심슨의 역설 설명도 제3요인과 관련된 반전 현상을 보여 줍니다.
관측 자료의 전체율은 ‘이번에 실제로 수행한 모든 문제에서 얼마나 성공했나’에 대한 답입니다. 그룹별 비교는 ‘같은 유형 안에서는 어느 쪽의 비율이 높았나’를 묻습니다. 두 질문은 다릅니다. 원하는 답이 무엇인지 먼저 정해야 숫자가 서로 모순처럼 보이지 않습니다.
같은 구성으로 비교한다면
쉬운 문제와 어려운 문제를 각각 50%로 둔 가상의 공통 구성을 적용해 보겠습니다. A는 (90% + 20%) ÷ 2 = 55%, B는 (95% + 30%) ÷ 2 = 62.5%입니다. 이 값은 원래 자료의 실제 전체율이 아니라, 동일한 구성에 맞춘 비교입니다. 50%를 고른 근거가 없는 실제 의사결정에서 이 값을 그대로 최종 답으로 쓰면 안 됩니다. 목표 모집단에 맞는 구성이 필요합니다.
그룹으로 나누면 항상 진실일까?
아닙니다. 어떤 변수로 나눌지에는 질문과 데이터가 생긴 과정이 중요합니다. 결과가 나온 뒤의 변수나 선택 과정에 영향을 받은 조건으로 함부로 나누면 또 다른 편향이 생길 수 있습니다. 이 표만으로 B가 모든 조건에서 원인적으로 더 우수하다고 결론낼 수도 없습니다. 무작위 배정, 기간, 대상의 차이, 빠진 변수 같은 정보가 추가로 필요합니다.
- 전체 비율과 함께 분자·분모를 확인합니다.
- 결과와 관련된 사전 조건의 구성 차이를 봅니다.
- 그룹별 표와 각 그룹의 표본 수를 표시합니다.
- 공통 구성 비교를 한다면 가중치의 이유를 설명합니다.
- 관측 비율과 원인·효과 주장 사이를 구분합니다.
핵심은 전체 숫자를 버리는 것이 아니라 그 숫자가 합쳐 놓은 서로 다른 조건을 읽는 것입니다. ‘전체로는 A, 그룹별로는 B’가 가능하다는 것을 알면 성급한 순위 대신 비교 질문과 분모를 먼저 확인하게 됩니다.
함께 읽으면 좋은 글
본문의 이해를 돕기 위해 제작한 설명용 삽화입니다.