PDF에서 검색이 안 될 때: OCR 후 꼭 확인할 다섯 가지
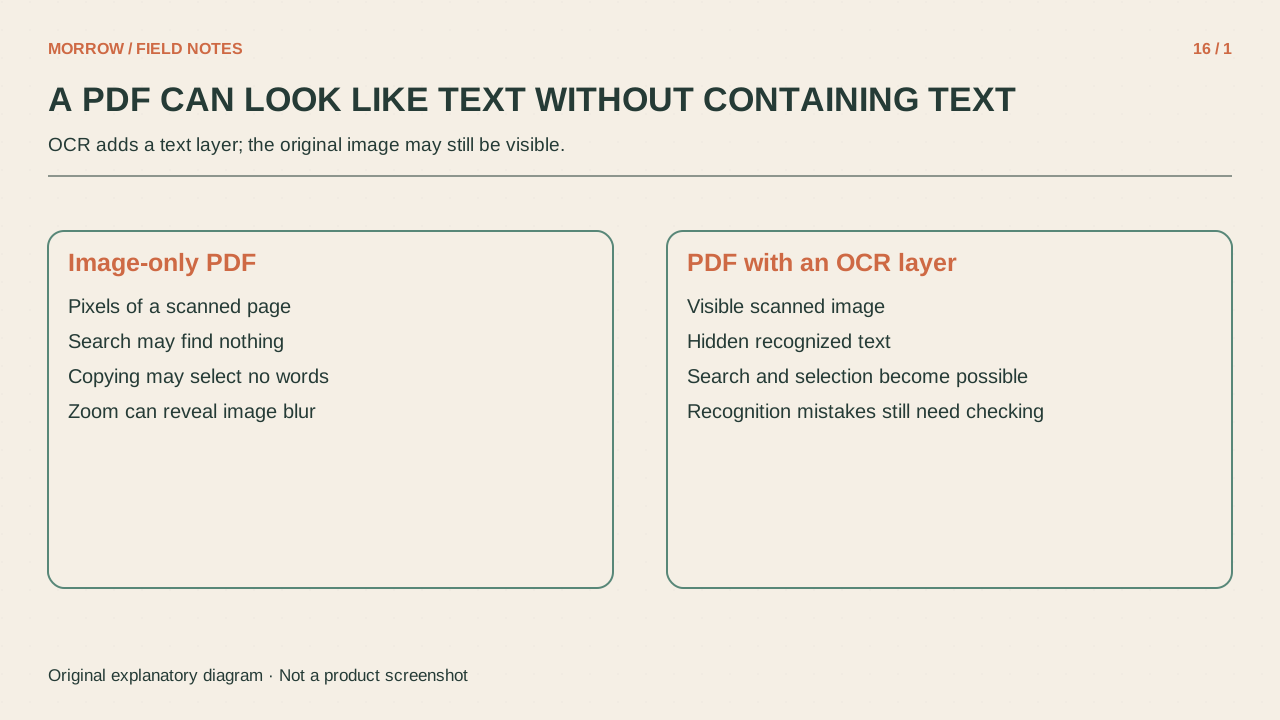
PDF에 글자가 선명하게 보이는데 검색 결과가 없을 수 있습니다. 화면의 글자가 텍스트가 아니라 촬영된 이미지일 수 있기 때문입니다. OCR은 이미지 속 문자를 인식해 검색 가능한 텍스트를 만드는 과정입니다. 하지만 검색이 된다는 것만으로 정확한 문서가 된 것은 아닙니다.
먼저 선택과 검색을 시험하기
알고 있는 문장 몇 단어를 드래그해 복사하고 메모장 같은 곳에 붙여 보세요. 파일 안에서 제목과 본문 단어를 각각 검색합니다. 어떤 페이지에서는 선택되고 다른 페이지에서는 안 된다면 텍스트와 스캔이 섞인 문서일 수 있습니다. 선택 제한이 있는 문서도 있으므로 복사 실패만으로 스캔이라고 단정하지 않습니다.
원본을 보존한 뒤 별도 사본에 OCR을 적용하세요. Acrobat 데스크톱에서는 Scan & OCR에서 문서 범위와 인식 언어를 지정할 수 있습니다. 기능과 메뉴 이름은 버전·계정에 따라 다를 수 있으므로 사용 중인 제품의 안내를 확인합니다.
보기 좋은 페이지와 정확한 텍스트를 구분
OCR 뒤에도 원래 스캔 이미지가 화면에 남고 텍스트가 검색용으로 추가될 수 있습니다. 그래서 페이지 외형이 깨끗해도 숨은 텍스트는 잘못 인식되었을 수 있습니다. ‘잘 보인다’와 ‘정확히 복사된다’는 따로 검사해야 합니다.
| 검사할 항목 | 실제 시험 | 흔한 문제 |
|---|---|---|
| 핵심 단어 | 알고 있는 단어 검색 | 단어 일부 누락 |
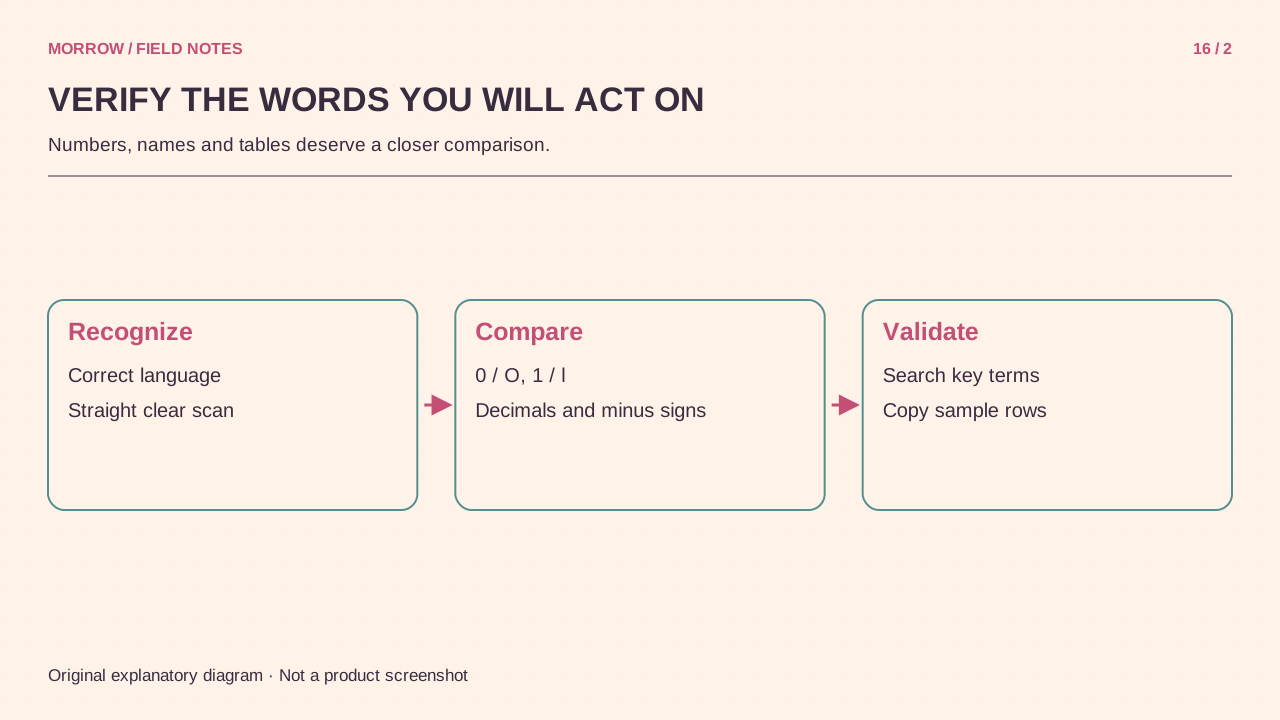
| 숫자 | 원본과 자리별 대조 | 0/O, 1/l 혼동 |
| 단위·기호 | 복사한 값과 화면 비교 | 소수점·마이너스 누락 |
| 표 | 한 행을 복사해 순서 확인 | 열과 행의 관계 손실 |
| 다단 본문 | 문단을 복사해 읽기 순서 확인 | 열 사이 문장 섞임 |
실패 페이지부터 다시 촬영하기
전체 문서를 반복 처리하기보다 오류가 있는 페이지를 찾으세요. 기울어짐, 흔들림, 그림자, 잘린 여백, 작은 문자부터 점검합니다. 종이를 평평하게 놓고 균일한 조명에서 다시 촬영하면 입력 자체를 개선할 수 있습니다. 화면 확대는 원본 이미지에 없던 문자를 복원하지 못합니다.
예를 들어 20쪽 안내서의 8쪽 표만 부정확하다면 그 페이지를 재촬영하고, 같은 언어 설정으로 처리한 뒤 표의 행을 대조합니다. 검증할 항목을 정하고 결과를 기록하면 재처리가 실제로 좋아졌는지 알 수 있습니다.
검색용과 데이터 추출용의 기준은 다르게
문서에서 장 제목을 찾으려는 용도와 표의 숫자를 스프레드시트로 옮기려는 용도는 필요한 정확도가 다릅니다. 데이터 추출이라면 옮기는 모든 중요 값과 단위를 원본으로 대조하세요. 검색이 잘 되는 PDF라도 표 구조와 읽기 순서가 정확하다는 보장은 없습니다. OCR은 문자를 만드는 단계이며 문서의 접근성이나 구조까지 자동으로 완성하는 인증이 아닙니다.
파일을 줄이기 위해 원본을 너무 강하게 압축하지 마세요. 검색용 사본과 원래 스캔을 함께 보관하면 오류를 발견했을 때 다시 확인할 근거가 남습니다. 작업 기록에는 처리 범위, 언어, 확인한 페이지, 남은 오류를 적으면 충분합니다.
공식 자료: Adobe 스캔 문서 텍스트 인식, Adobe 검색용 숨은 OCR 텍스트 설명. 검사표는 원본 대조를 위한 본 글의 실무 예입니다.
함께 읽으면 좋은 글
본문의 이해를 돕기 위해 제작한 설명용 삽화입니다.