Pythonのリスト・タプル・辞書・セットの違いと使い分け
この記事はAIの支援を受けて原文を翻訳したものです。専門用語や数式は原文とあわせて確認してください。
Pythonのリスト(list)は「順序があり、中身を変更できる」コレクション、タプル(tuple)は「順序はあるが、変更できない」コレクション、辞書(dict)はキーと値を対応づけるもの、セット(set/集合)は重複のない要素を順序なしで持つものです。追加・並べ替え・位置指定をする順序つきのデータにはリスト、座標のように固定された組にはタプル、名前やIDで引くなら辞書、重複を除いたり「含まれているか」を調べたりするならセットが向いています。とくに差が出るのが最後の判定で、セットと辞書は x in ... に平均してほぼ一定時間で答えますが、リストとタプルは要素を1つずつ確認していきます。
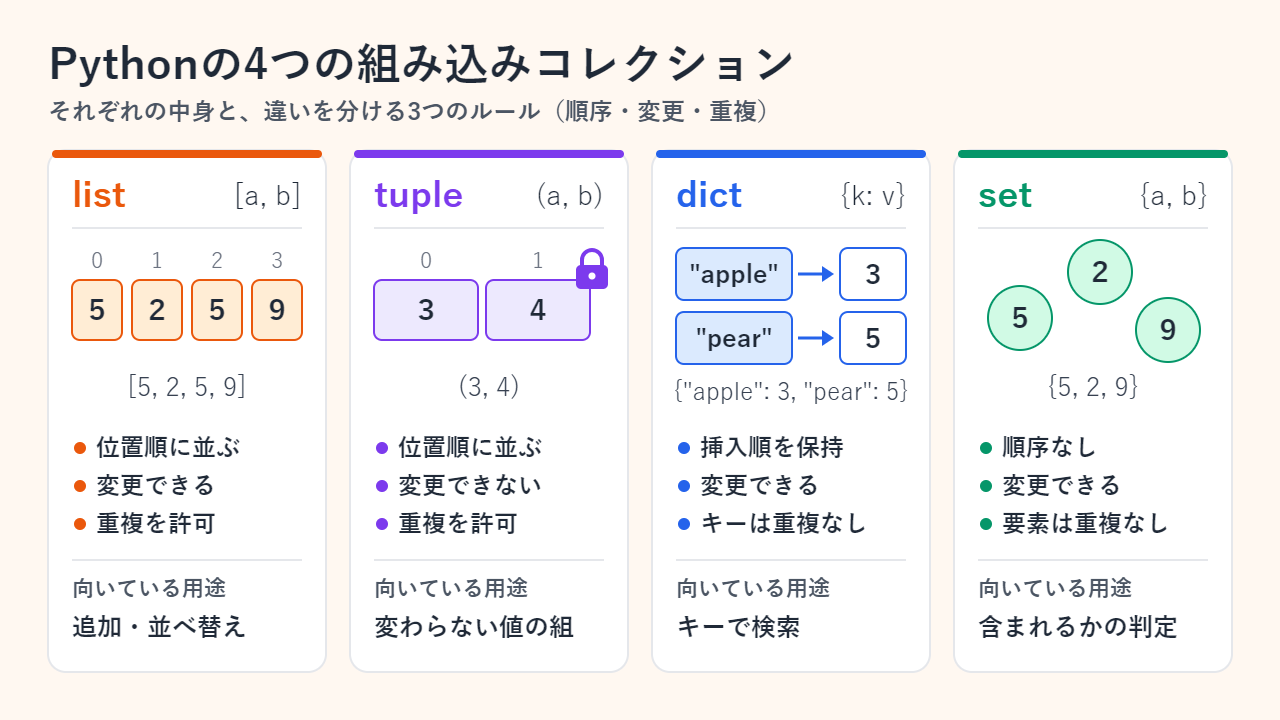
書き方の比較と、初心者がつまずく2つの落とし穴
4つとも専用の書き方(リテラル)があり、最初につまずきやすいのもここです。
scores = [90, 75, 90]             # リスト:角括弧
point  = (3, 4)                   # タプル:丸括弧(正確にはカンマ)
stock  = {"apple": 3, "pear": 5}  # 辞書:波括弧に「キー: 値」
tags   = {"red", "green"}         # セット:波括弧に値だけ

empty_dict = {}       # {} は空の辞書(セットではない)
empty_set  = set()    # 空のセットはこの書き方しかない
one_tuple = (42,) # (42) はただの整数の42落とし穴の1つ目は、{} が空の辞書になることです。空のセットは set() と書かなければなりません。2つ目は、タプルを作るのは丸括弧ではなくカンマだということです。(42) は丸括弧で囲んだ整数にすぎず、要素が1つのタプルは (42,)(あるいは 42,)と書きます。空のリストと空のタプルは、それぞれ [] と () です。
比較表:変更可否・順序・重複・ハッシュ可能性
| 項目 | list(リスト) | tuple(タプル) | dict(辞書) | set(セット) |
|---|---|---|---|---|
| その場で変更できるか(ミュータブルか) | できる | できない | できる | できる |
| 順序 | あり(位置順) | あり(位置順) | あり(挿入順) | なし |
| 重複 | 許可 | 許可 | キーは重複不可(値は重複可) | 不可 |
| 取り出し方 | インデックス:a[0] | インデックス:t[0] | キー:d["apple"] | インデックスは使えず、in かループで確認 |
| ハッシュ可能か(キーや要素にできるか) | 不可 | 要素がすべてハッシュ可能なら可 | 不可 | 不可(frozenset なら可) |
x in c(平均) | O(n) | O(n) | O(1) | O(1) |
補足が必要な行が2つあります。まず、辞書の「順序あり」は、追加した順番(挿入順)を覚えているという意味で、ソート済みという意味ではありません。Python 3.7から言語仕様として保証されており、CPython 3.6では実装の詳細として先に実現されていました。セットには順序がまったくないため、インデックスで取り出すことはできず、print したときの並び順も当てにしてはいけません。次に「ハッシュ可能(hashable)」は、辞書のキーやセットの要素にできるかどうかを決める条件です。ハッシュ値が生存期間中ずっと変わらないオブジェクトである必要があるので、リスト・辞書・セットは使えません。タプルは中身がすべてハッシュ可能なときだけ該当し、(1, 2) はキーにできますが ([1], 2) はできません。
使い分けの考え方:3つの質問とデフォルト
どれを選ぶかは、データを「あとでどう読み出すか」で決まります。次の質問を上から順に確認してください。
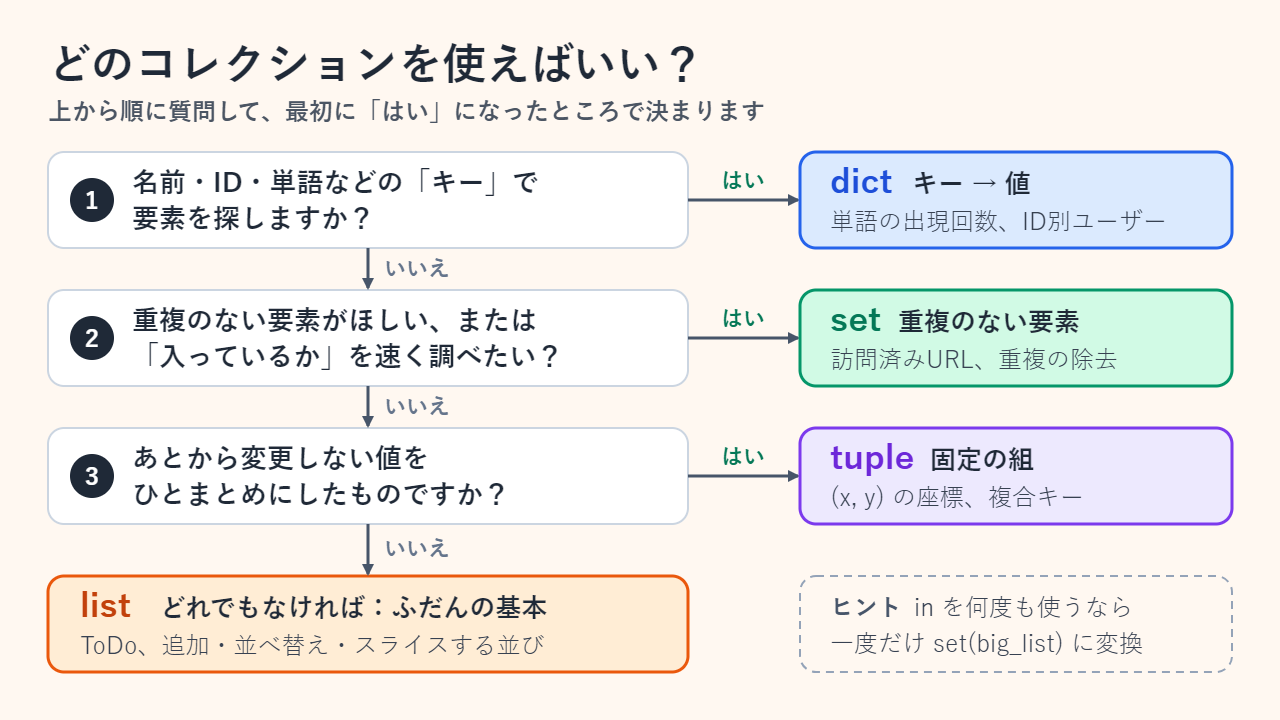
- ユーザー名・商品コード・単語など、キーで探しますか? それなら辞書です。キーと値のペアを並べたリストを端から探すより、
prices["apple"]のほうが読みやすく、速くもなります。 - 「入っているかどうか」だけが知りたい、または各要素を1つずつ持ちたいですか? それならセットです。訪問済みのURL、禁止ワード、重複しないタグなどが典型例です。
- まとまりで意味を持つ、変わらない値ですか? (x, y) の座標、RGBの色、関数が返す複数の値などはタプルが向いています。「この値は変更しない」という意思表示にもなり、
distance[("東京", "大阪")]のように、複数の値を組み合わせた辞書のキーにもできます。 - どれにも当てはまらなければリストです。追加・並べ替え・スライス・位置での参照をしたい、順序つきの並びに使います。
相互変換の方法
list(t)とtuple(lst)は、順序を保ったまま要素をもう一方のシーケンス型にコピーします。set(lst)は重複を取り除きますが、順序は失われます。list(dict.fromkeys(lst))は、辞書が挿入順を保つ性質を利用して、最初に現れた順序のまま重複を取り除きます。["b", "a", "b"]は["b", "a"]になります。dict(zip(keys, values))は、2つのリストを組み合わせて辞書にします。list(d)でキーを挿入順に取り出せ、list(d.items())なら(キー, 値)のタプルのリストになります。sorted(s)は、セットに限らずどんなコレクションからでも、ソート済みの新しいリストを作ります。
なぜセットと辞書の in は速く、リストの in は遅いのか
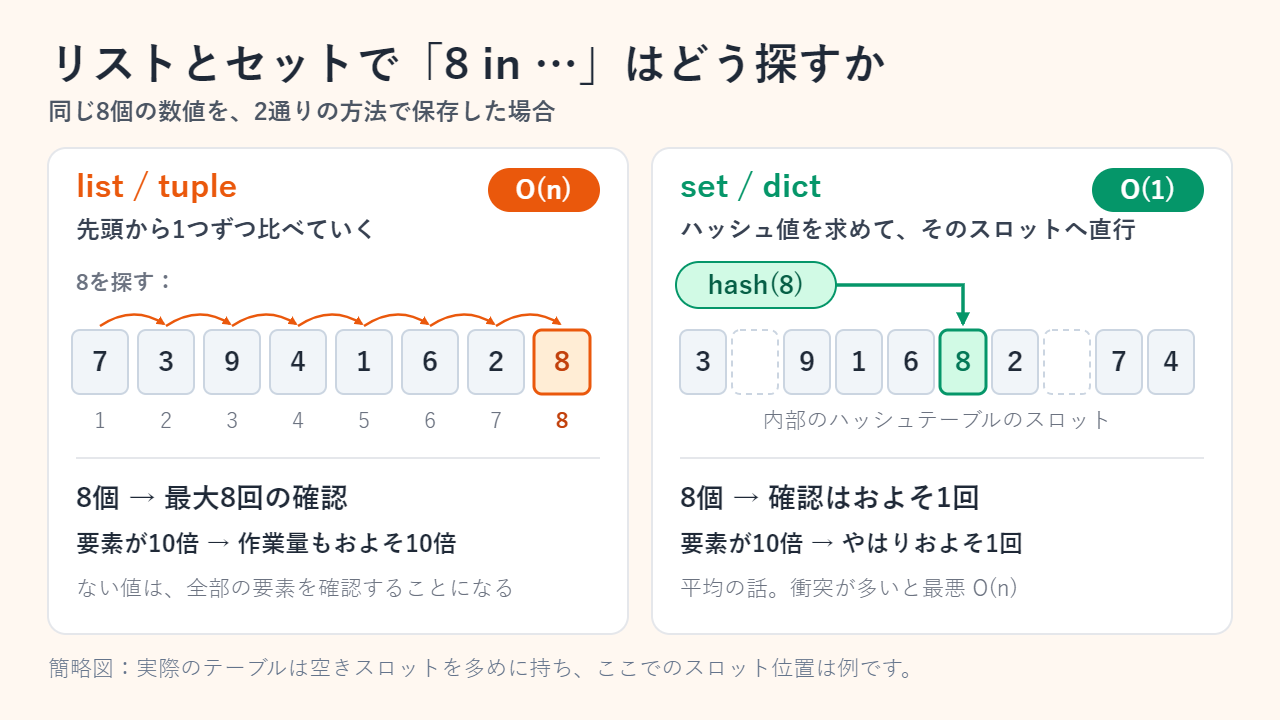
x in my_list という判定(メンバーシップテスト)では、Pythonは先頭から順に x と各要素を比べ、一致するところまで進みます。x が含まれていない場合や末尾近くにある場合は、n個の要素に対してn回の比較が必要です。Python Wikiがこの操作を O(n) と記載しているのはそのためで、タプルも同じ仕組みです。一方、セットや辞書は hash(x) を計算し、その値を手がかりに内部テーブルの1か所へ直接移動して、そこにあるものだけを確認します。Wikiでは、どちらも平均で O(1) とされています。最悪の場合は O(n) ですが、それはハッシュ衝突が大量に起きたときだけです。
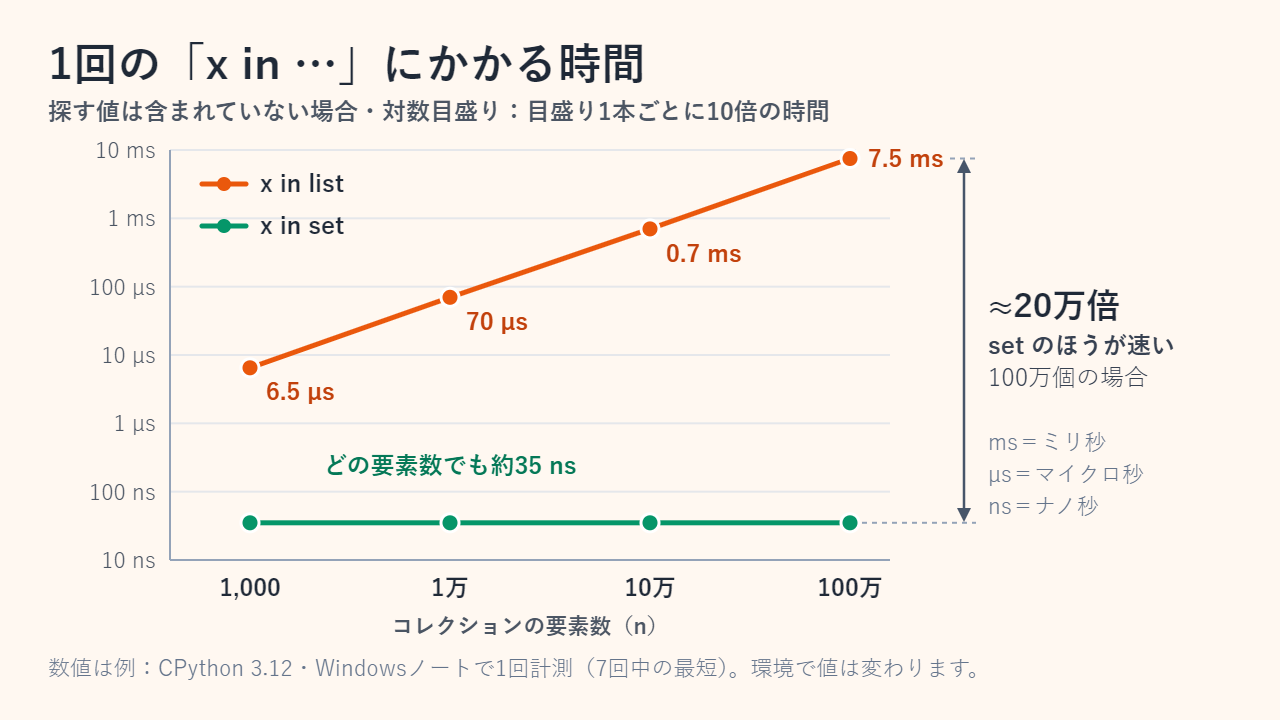
要素数が増えるほど差は開きます。次の数値は、あくまで例として1回計測した結果です(Windowsのノートパソコン上のCPython 3.12で、コレクションに含まれない数値を探し、7回繰り返して最も速い値を採用)。リストは、要素1,000個で約6.5 µs(マイクロ秒)、1万個で約70 µs、10万個で約0.7 ms(ミリ秒)、100万個で約7.5 msかかりました。セットはどの要素数でも約35 ns(ナノ秒)で、100万個の場合は約20万倍も速かったことになります。お使いの環境では数値が変わりますが、傾向は変わりません。要素数が10倍になると、リストは約10倍の時間がかかり、セットはほとんど変わりません。
実践的なルールは、何度も「含まれているか」を調べるなら、allowed = set(big_list) のように一度だけ変換し、そのセットに対して判定することです。セットの構築にはデータを1回走査する時間がかかるため、効果が出るのは繰り返し判定する場合です。1回だけ調べるなら、変換する必要はありません。
やりがちな間違い6つ
- 空のセットを
{}と書く。 実際には空の辞書ができ、.add()を呼ぶと AttributeError になります。 - 要素1つのタプルでカンマを忘れる。
("admin")はただの文字列なので、ループすると1文字ずつ取り出されます。 - リストを辞書のキーやセットの要素にする。
TypeError: unhashable type: 'list'が発生します。先にtuple()で変換してください。 - ループ中にコレクションを変更する。
for x in numsの中でリストから要素を削除すると、要素が飛ばされます。[1, 2, 2, 3]から2をすべて削除したつもりでも、結果は[1, 2, 3]で、2が1つ残ります。辞書のキーをループ中に追加・削除すると RuntimeError("dictionary changed size during iteration")になり、セットも同様です。新しいコレクションを作る([x for x in nums if x != 2])か、list(d)のようにコピーに対してループしましょう。 - タプルの中身は絶対に変わらないと思い込む。 タプル自体は固定ですが、中に入れたリストは変更できます。そのようなタプルはハッシュ化もできません。
- ループの中で大きなリストを検索する。
if user in banned_listのような判定を何千回も繰り返すのは、気づきにくい遅さの典型例です。セットにすれば解消します。
よくある質問
タプルはリストより速いですか?
わずかに軽量ですが、体感できるほどの差になることはあまりありません。64ビット版CPython 3.12では、sys.getsizeof((1, 2, 3)) が64バイト、sys.getsizeof([1, 2, 3]) が88バイトを返します(この値は環境やバージョンによって変わります)。速度ではなく、「データを変更しない」ことを示したいときにタプルを選びましょう。
Pythonの辞書は順序を保持しますか?
はい。Python 3.7から、辞書は挿入順を保持することが言語仕様として保証されています。ループすると、追加した順にキーが取り出されます。セットにはそのような保証はありません。
辞書に同じキーを複数登録できますか?
できません。すでにあるキーに代入すると値が置き換わるため、{"a": 1, "a": 2} は {"a": 2} になります。値のほうは重複しても構いません。
参考資料:Python チュートリアル:データ構造、Python ドキュメント:組み込み型、Python Wiki:TimeComplexity(計算量の一覧、英語)、Python 用語集(ハッシュ可能・イミュータブル)。
関連記事
本文の理解を助けるために制作したオリジナルイラストです。