파이썬 리스트 튜플 딕셔너리 셋 차이, 언제 무엇을 쓸까
이 글은 AI의 도움을 받아 원문을 번역한 글입니다. 전문 용어와 수식은 원문과 함께 확인해 주세요.
파이썬 리스트(list)는 순서가 있고 내용을 바꿀 수 있는 모음, 튜플(tuple)은 순서는 있지만 한 번 만들면 바꿀 수 없는 모음, 딕셔너리(dict)는 고유한 키에 값을 짝지어 저장하는 자료형, 셋(set, 집합)은 중복 없는 항목을 순서 없이 담는 자료형입니다. 항목을 추가·정렬하거나 인덱스로 꺼내려면 리스트, 좌표처럼 고정된 묶음이면 튜플, 이름이나 ID로 값을 찾으려면 딕셔너리, 중복을 없애거나 “이 값이 들어 있나?”를 확인하려면 셋이 알맞습니다. 속도 차이가 가장 큰 곳은 마지막 질문입니다. 셋과 딕셔너리는 x in ... 검사를 평균적으로 거의 일정한 시간에 끝내지만, 리스트와 튜플은 항목을 하나씩 확인합니다.
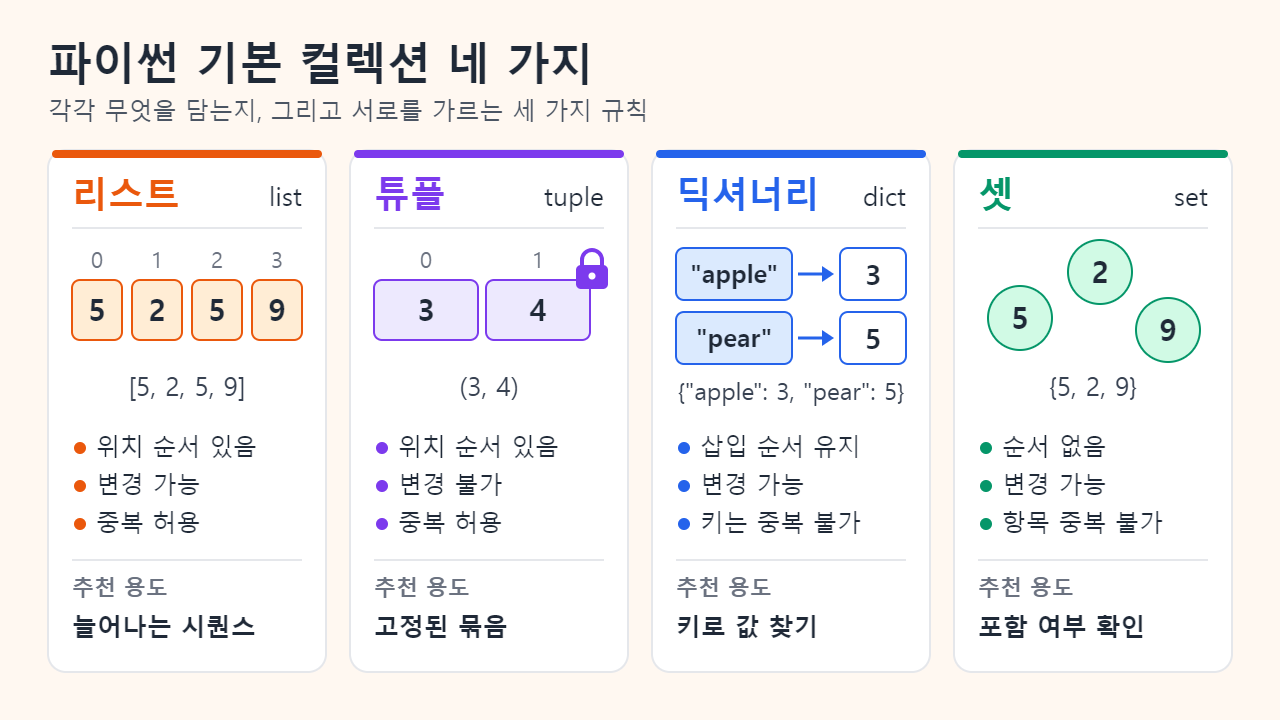
문법 비교와 흔한 함정 두 가지
네 자료형은 모두 괄호만으로 만들 수 있고, 초보자가 가장 먼저 헷갈리는 곳도 여기입니다.
scores = [90, 75, 90]             # 리스트: 대괄호
point  = (3, 4)                   # 튜플: 소괄호 (정확히는 쉼표)
stock  = {"apple": 3, "pear": 5}  # 딕셔너리: 중괄호 + 키: 값 쌍
tags   = {"red", "green"}         # 셋: 중괄호 + 값만 나열

empty_dict = {}       # {}는 빈 딕셔너리이지 빈 셋이 아닙니다
empty_set  = set()    # 빈 셋을 만드는 유일한 방법
one_tuple  = (42,)    # (42)는 그냥 숫자 42입니다
첫 번째 함정은 {}입니다. 중괄호만 쓰면 빈 셋이 아니라 빈 딕셔너리가 만들어지므로, 빈 셋은 반드시 set()으로 써야 합니다. 두 번째 함정은 쉼표입니다. 튜플을 만드는 것은 소괄호가 아니라 쉼표여서, (42)는 괄호로 감싼 정수일 뿐이고 (42,)나 42,처럼 쉼표를 붙여야 항목이 하나인 튜플이 됩니다. 빈 리스트와 빈 튜플은 각각 [], ()로 간단히 씁니다.
한눈에 보는 비교표: 변경 가능 여부, 순서, 중복, 해시
| 특성 | 리스트(list) | 튜플(tuple) | 딕셔너리(dict) | 셋(set) |
|---|---|---|---|---|
| 만든 뒤 내용 변경(mutable) | 가능 | 불가능 | 가능 | 가능 |
| 순서 | 있음(위치 기준) | 있음(위치 기준) | 있음(삽입 순서) | 없음 |
| 중복 | 허용 | 허용 | 키는 중복 불가, 값은 중복 가능 | 허용 안 함 |
| 접근 방법 | 인덱스: a[0] | 인덱스: t[0] | 키: d["apple"] | 인덱스 불가, in이나 반복문 사용 |
| 해시 가능(hashable, 키로 사용 가능) | 불가능 | 안의 항목이 모두 해시 가능하면 가능 | 불가능 | 불가능(frozenset은 가능) |
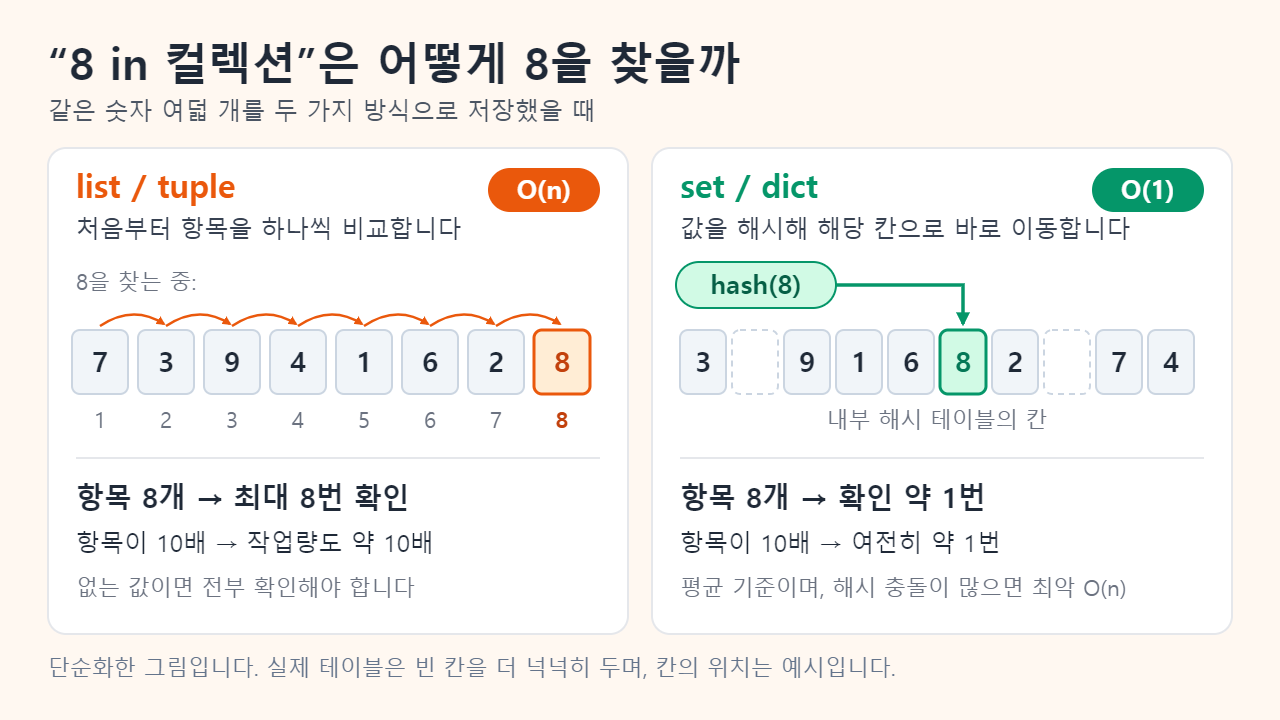
x in c 평균 시간 | O(n) | O(n) | O(1) | O(1) |
두 줄에는 부연이 필요합니다. 딕셔너리의 “순서 있음”은 넣은 순서(삽입 순서)를 기억한다는 뜻이지, 키나 값을 기준으로 정렬되어 있다는 뜻이 아닙니다. 이 동작은 파이썬 3.7부터 언어 차원에서 보장되며, CPython 3.6에서는 구현상의 특징이었습니다. 셋에는 순서 개념 자체가 없어서 인덱스로 꺼낼 수 없고, print로 보이는 순서에 기대서도 안 됩니다. “해시 가능”은 딕셔너리의 키나 셋의 원소가 될 수 있는지를 정하는 조건입니다. 해시값이 변하면 안 되므로 내용을 바꿀 수 있는 리스트·딕셔너리·셋은 제외됩니다. 튜플은 안에 든 항목이 모두 해시 가능할 때만 해시 가능해서, (1, 2)는 키로 쓸 수 있지만 ([1], 2)는 쓸 수 없습니다.
어떤 자료형을 쓸까: 질문 세 개와 기본값
자료형은 데이터를 나중에 어떻게 읽을지에 따라 고릅니다. 아래 질문을 순서대로 던져 보세요.
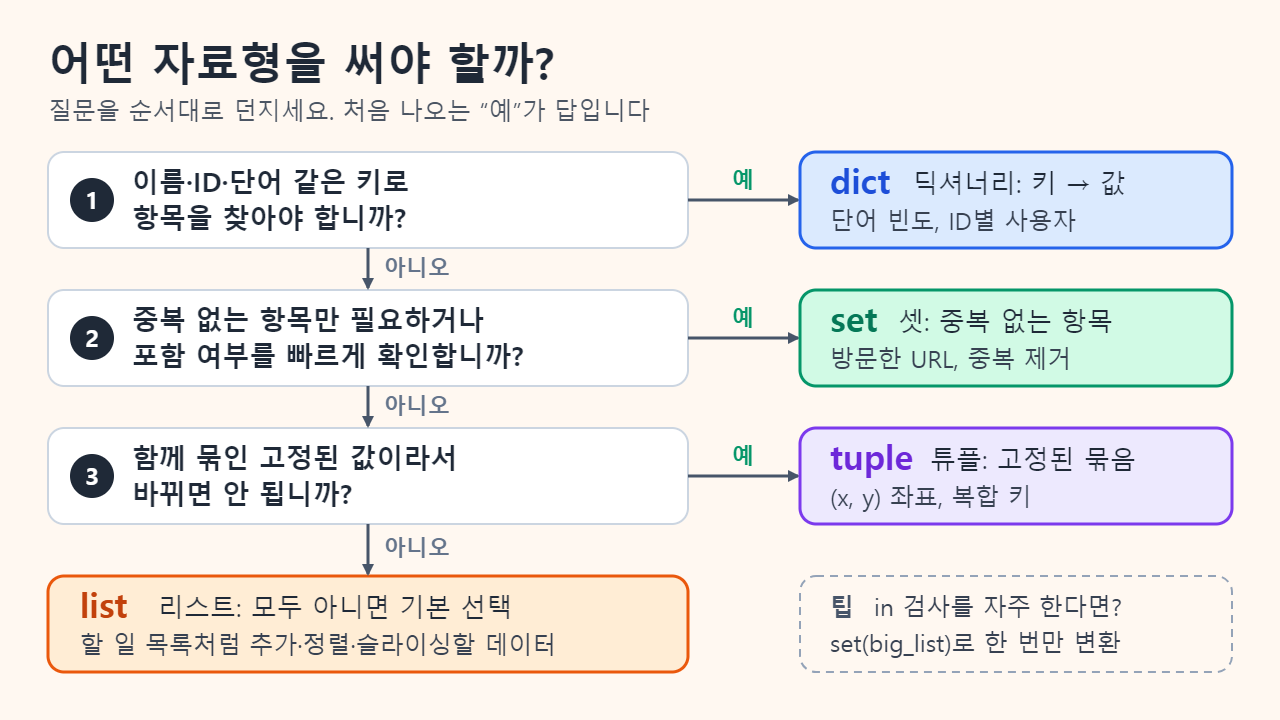
- 이름·상품 코드·단어 같은 키로 항목을 찾습니까? 그렇다면 딕셔너리입니다. 쌍으로 된 리스트를 뒤지는 것보다
prices["apple"]이 읽기도 쉽고 빠릅니다. - 값이 들어 있는지만 알면 되거나 항목을 한 번씩만 두고 싶습니까? 그렇다면 셋입니다. 방문한 URL, 금칙어, 중복 없는 태그가 그런 예입니다.
- 함께 묶여 다니는 고정된 값입니까? (x, y) 좌표, RGB 색, 함수가 돌려주는 여러 값이 그런 예이며 튜플이 어울립니다. 바뀌지 않는다는 의도가 코드에 드러나고,
distance[("서울", "부산")]처럼 여러 값으로 된 딕셔너리 키로도 쓸 수 있습니다. - 그 외에는 리스트입니다.
append로 붙이고 정렬·슬라이싱하며 위치로 꺼내는 순서 있는 시퀀스가 필요할 때입니다.
자료형끼리 변환하는 방법
list(t)와tuple(lst)는 항목을 다른 시퀀스 자료형으로 복사하며 순서를 그대로 유지합니다.set(lst)는 중복을 없애 주지만 순서는 사라집니다.list(dict.fromkeys(lst))는 중복을 없애면서 처음 나온 순서를 유지합니다. 딕셔너리가 삽입 순서를 보존하기 때문이며,["b", "a", "b"]는["b", "a"]가 됩니다.dict(zip(keys, values))는 리스트 두 개를 짝지어 딕셔너리로 만들고,list(d)는 키를,list(d.items())는 (키, 값) 튜플을 삽입 순서대로 돌려줍니다.sorted(s)는 셋을 비롯한 모든 컬렉션을 정렬된 새 리스트로 바꿔 줍니다.
셋과 딕셔너리는 in 연산이 빠르고 리스트는 느린 이유
x in my_list를 실행할 때 파이썬은 처음부터 x를 원소와 하나씩 비교하다가 같은 값을 찾으면 멈춥니다. x가 없거나 끝 쪽에 있으면 항목이 n개일 때 비교를 n번 해야 하고, 그래서 파이썬 위키는 이 연산을 O(n)으로 기록합니다. 튜플도 같은 방식으로 동작합니다. 반면 셋이나 딕셔너리는 hash(x)를 계산해 내부 테이블의 한 칸으로 곧장 이동하고 그 칸에 있는 것만 확인합니다. 위키는 두 자료형 모두 평균 O(1)이라고 적고 있으며, 해시 충돌이 많이 일어나는 최악의 경우에만 O(n)이 됩니다.
데이터가 커질수록 차이도 벌어집니다. 다음은 한 번 측정한 예시 수치입니다(Windows 노트북, CPython 3.12, 컬렉션에 없는 숫자 검색, 7회 반복 중 최고 기록). 리스트는 항목 1,000개에서 약 6.5µs(마이크로초), 1만 개에서 70µs, 10만 개에서 0.7ms(밀리초), 100만 개에서 7.5ms가 걸렸습니다. 셋은 어떤 크기에서도 약 35ns(나노초)였고, 100만 개에서는 약 20만 배 빨랐습니다. 수치는 환경마다 다르겠지만 경향은 같습니다. 항목이 10배 늘면 리스트는 약 10배 오래 걸리고, 셋은 거의 달라지지 않습니다.
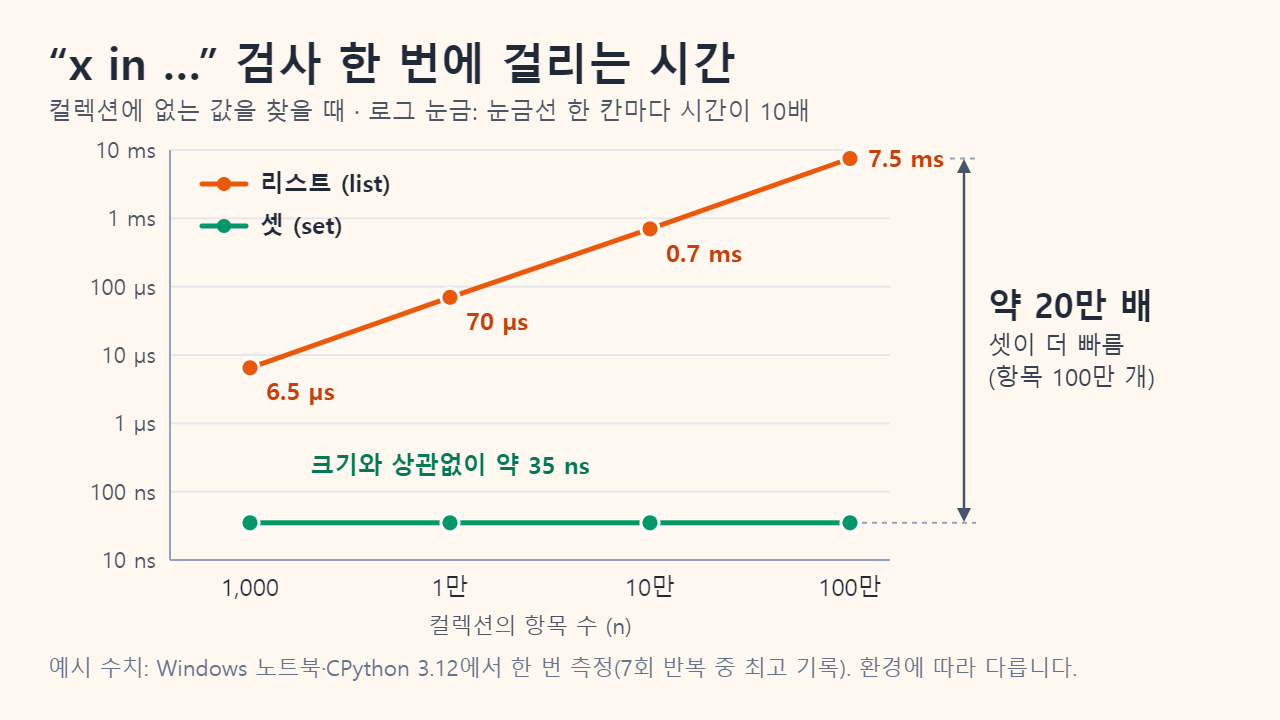
실전에서 포함 여부를 여러 번 검사해야 한다면 allowed = set(big_list)처럼 한 번만 변환해 두고 셋을 대상으로 검사하세요. 셋을 만들 때 데이터를 한 번 훑어야 하므로 반복 검사에서만 이득입니다.
자주 하는 실수 여섯 가지
- 빈 셋을
{}로 쓰는 실수. 딕셔너리가 만들어져서.add()를 호출하면 AttributeError가 발생합니다. - 항목이 하나인 튜플에서 쉼표를 빼먹는 실수.
("admin")은 그냥 문자열이라서 반복문으로 돌리면 글자가 하나씩 나옵니다. - 리스트를 딕셔너리 키나 셋의 원소로 쓰는 실수.
TypeError: unhashable type: 'list'오류가 납니다. 먼저tuple()로 바꿔 주세요. - 반복하는 도중에 그 컬렉션을 수정하는 실수.
for x in nums안에서 리스트의 항목을 지우면 원소를 건너뜁니다.[1, 2, 2, 3]에서 2를 이렇게 모두 지우려 하면 2 하나가 건너뛰어져[1, 2, 3]이 남습니다. 딕셔너리 키를 반복 중에 추가·삭제하면 RuntimeError(“dictionary changed size during iteration”)가 발생하고, 셋도 마찬가지입니다.[x for x in nums if x != 2]처럼 새 컬렉션을 만들거나list(d)처럼 복사본을 순회하세요. - 튜플의 내용이 절대 바뀌지 않는다고 믿는 실수. 튜플 자체는 고정이지만 그 안에 든 리스트는 얼마든지 수정할 수 있으며, 그런 튜플은 해시도 불가능합니다.
- 반복문 안에서 큰 리스트를 검색하는 실수.
if user in banned_list같은 검사를 수천 번 반복하면 눈에 띄지 않게 느려지는 대표적인 원인이며, 셋으로 바꾸면 해결됩니다.
자주 묻는 질문
튜플이 리스트보다 빠른가요?
조금 가볍기는 하지만 체감할 만한 차이는 드뭅니다. 64비트 CPython 3.12에서 sys.getsizeof((1, 2, 3))은 64바이트, sys.getsizeof([1, 2, 3])은 88바이트를 보고합니다(버전에 따라 다를 수 있습니다). 속도 때문이 아니라 데이터가 바뀌면 안 되기 때문에 튜플을 고르세요.
파이썬 딕셔너리는 순서가 있나요?
네. 파이썬 3.7부터 삽입 순서 유지가 보장되어, 반복하면 키가 추가된 순서대로 나옵니다. 셋에는 이런 보장이 없습니다.
딕셔너리에 같은 키를 두 번 쓸 수 있나요?
아니요. 이미 있는 키에 다시 값을 대입하면 값이 교체되어, {"a": 1, "a": 2}는 {"a": 2}가 됩니다. 값은 중복 가능합니다.
참고 자료: 파이썬 자습서: 자료 구조, 파이썬 문서: 내장 자료형(영문), 파이썬 위키: TimeComplexity(영문), 파이썬 용어집(해시 가능 항목)
함께 읽으면 좋은 글
본문의 이해를 돕기 위해 제작한 설명용 삽화입니다.