Python列表、元组、字典、集合的区别与使用场景
本文在AI辅助下由原文翻译而成。请结合原文核对专业术语和公式。
Python的列表(list)是有序、可变的序列,元组(tuple)是有序但不可变的序列,字典(dict)以键值对保存数据,键不能重复,集合(set)只保存不重复的元素,没有固定顺序。要追加、排序、按位置取值,用列表;坐标这类固定数据,用元组;按名称或编号查值,用字典;去重或判断“在不在里面”,用集合。最后这一点的速度差别最大:集合和字典判断 x in ... 平均接近常数时间,列表和元组要逐个比较。
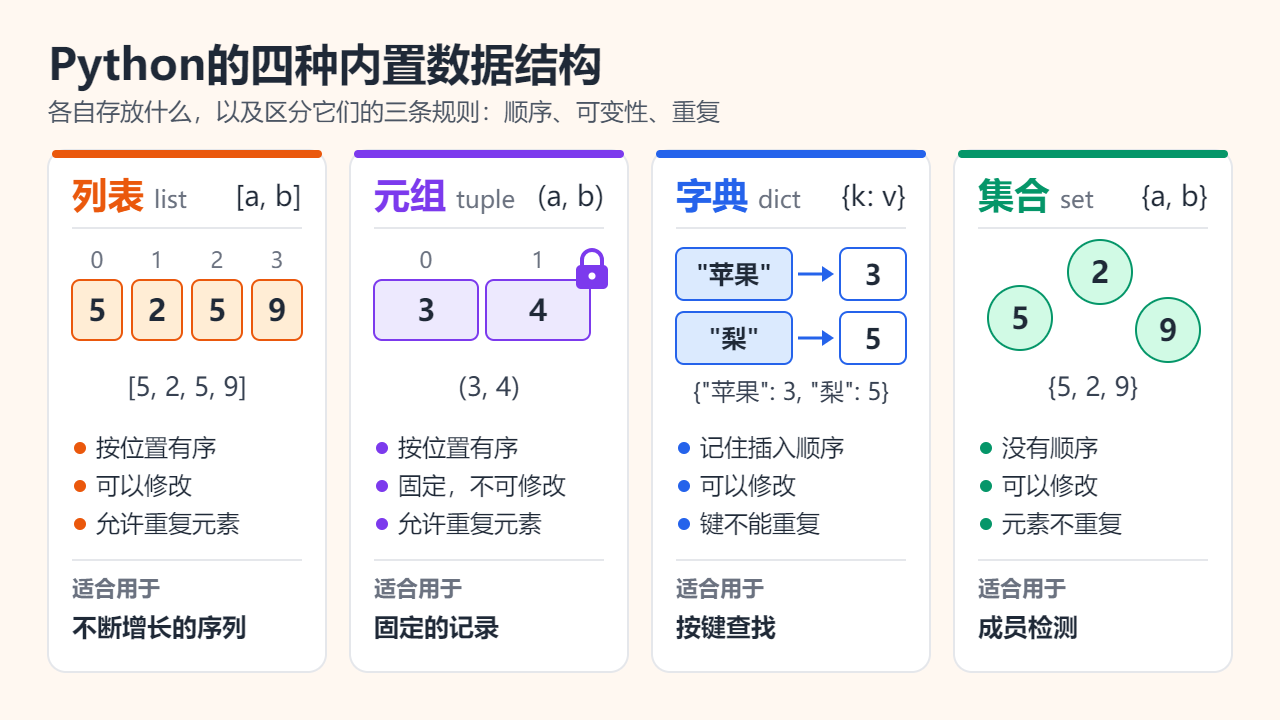
四种写法并排看,再认识两个陷阱
先看四种字面量写法:
scores = [90, 75, 90]             # 列表:方括号
point  = (3, 4)                   # 元组:圆括号
stock  = {"苹果": 3, "梨": 5}     # 字典:花括号,键: 值
tags   = {"红", "绿"}             # 集合:花括号,只有元素

empty_dict = {}       # 这是空字典,不是空集合
empty_set  = set()    # 空集合只能这样写
one_tuple = (42,) # (42) 只是整数 42陷阱一:{} 创建的是空字典,空集合必须写成 set()。陷阱二:构成元组的是逗号而不是圆括号,(42) 只是整数,(42,)(或直接写 42,)才是单元素元组。空列表和空元组分别是 [] 和 ()。
区别对比表:可变性、顺序、重复与可哈希
| 特性 | 列表 | 元组 | 字典 | 集合 |
|---|---|---|---|---|
| 能否原地修改 | 能 | 不能 | 能 | 能 |
| 是否有序 | 有序(按位置) | 有序(按位置) | 有序(按插入顺序) | 无序 |
| 允许重复吗 | 允许 | 允许 | 键唯一,值可重复 | 不允许 |
| 访问方式 | 下标:a[0] | 下标:t[0] | 键:d["苹果"] | 不支持下标,用 in 或循环 |
| 可哈希(能当键)吗 | 不可哈希 | 元素都可哈希时才可哈希 | 不可哈希 | 不可哈希(frozenset 可以) |
x in c 的平均复杂度 | O(n) | O(n) | O(1) | O(1) |
“有序”对字典而言是记住插入顺序,这从 Python 3.7 起成为语言规范的保证(CPython 3.6 已如此,但只是实现细节),并不是排好序。集合完全无序,不能用下标,打印出的顺序也不能依赖。“可哈希”决定了谁能当字典的键或集合的元素:对象需要一个在整个生命周期内不变的哈希值,因此列表、字典、集合都不行;元组仅当内部元素全部可哈希时才可哈希,所以 (1, 2) 能当键,([1], 2) 不能。
怎么选:三个问题加一个默认答案
该用哪种结构,取决于之后怎样读取数据。按顺序问自己:
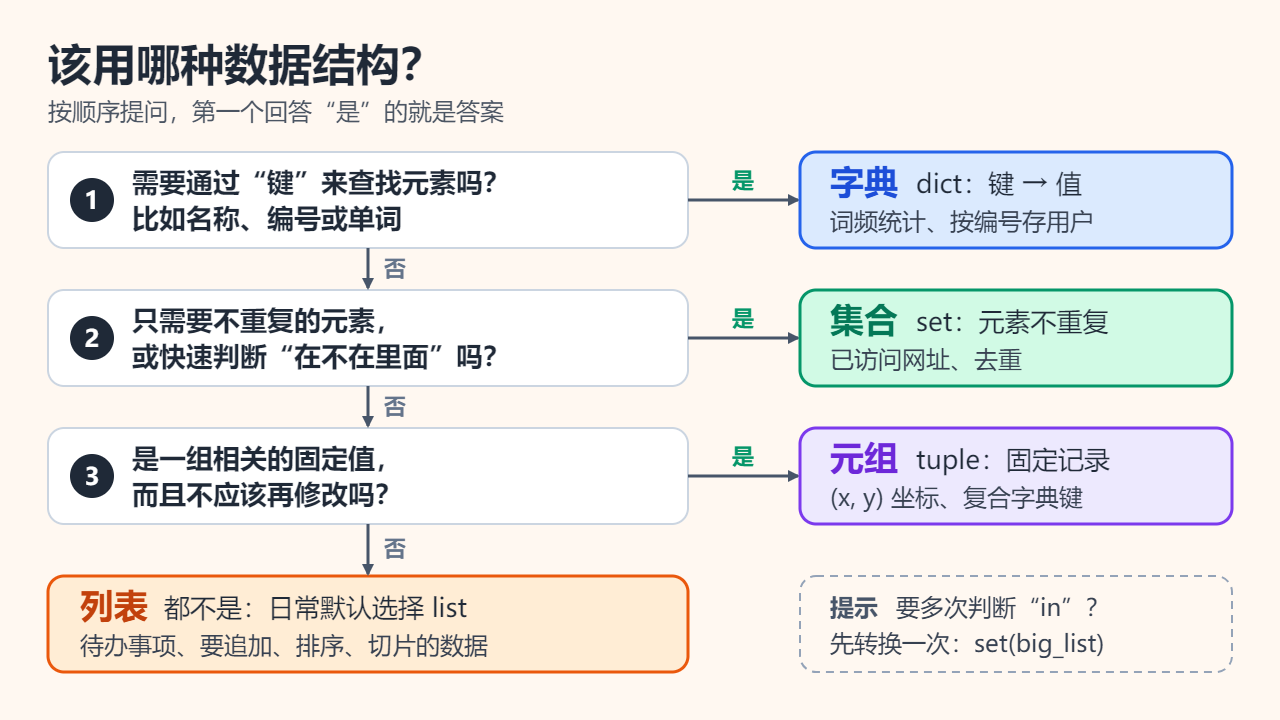
- 要按键查找吗?比如用户名、商品编码、单词。用字典:
prices["苹果"]比在“键值对”列表里逐个翻找更清楚,也更快。 - 只关心某个值在不在,或每个值只要一份?用集合:已访问网址、屏蔽词、去重后的标签。
- 是一组相关且固定的值吗?例如 (x, y) 坐标、RGB颜色、函数返回的多个值。用元组。它表明“这组数据不会变”,还能当多部分组成的字典键,如
distance[("北京", "上海")]。 - 都不是,就用列表。它是有序序列,可追加、排序、切片,也能按位置取值。
互相转换
list(t)和tuple(lst):复制成另一种序列,顺序不变。set(lst):去重,但顺序丢失。list(dict.fromkeys(lst)):去重并保留首次出现的顺序(字典保持插入顺序):["b", "a", "b"]变成["b", "a"]。dict(zip(keys, values)):把两个列表配成字典;list(d)按插入顺序返回所有键,list(d.items())返回(键,值)元组。sorted(s):把集合或其他容器变成新的有序列表。
为什么集合和字典的 in 判断很快,列表却很慢
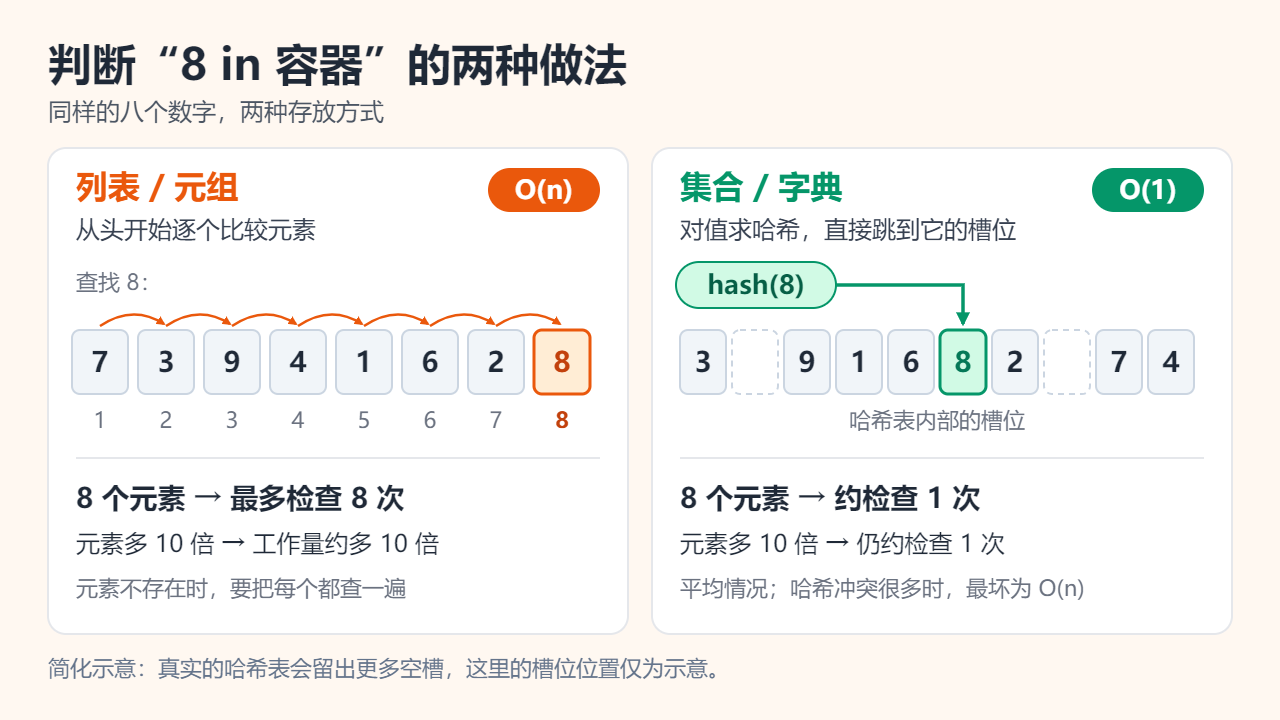
执行 x in my_list 时,Python 从头开始把 x 与元素逐个比较,直到找到相等的为止。x 不存在或靠后时,n 个元素就要比较 n 次,所以 Python 官方 Wiki 把它标为 O(n);元组同理。集合和字典则先算 hash(x),直接跳到内部哈希表的某个槽位,只检查那里。Wiki 给出的平均复杂度是 O(1),最坏情况 O(n) 只在大量哈希冲突时出现。
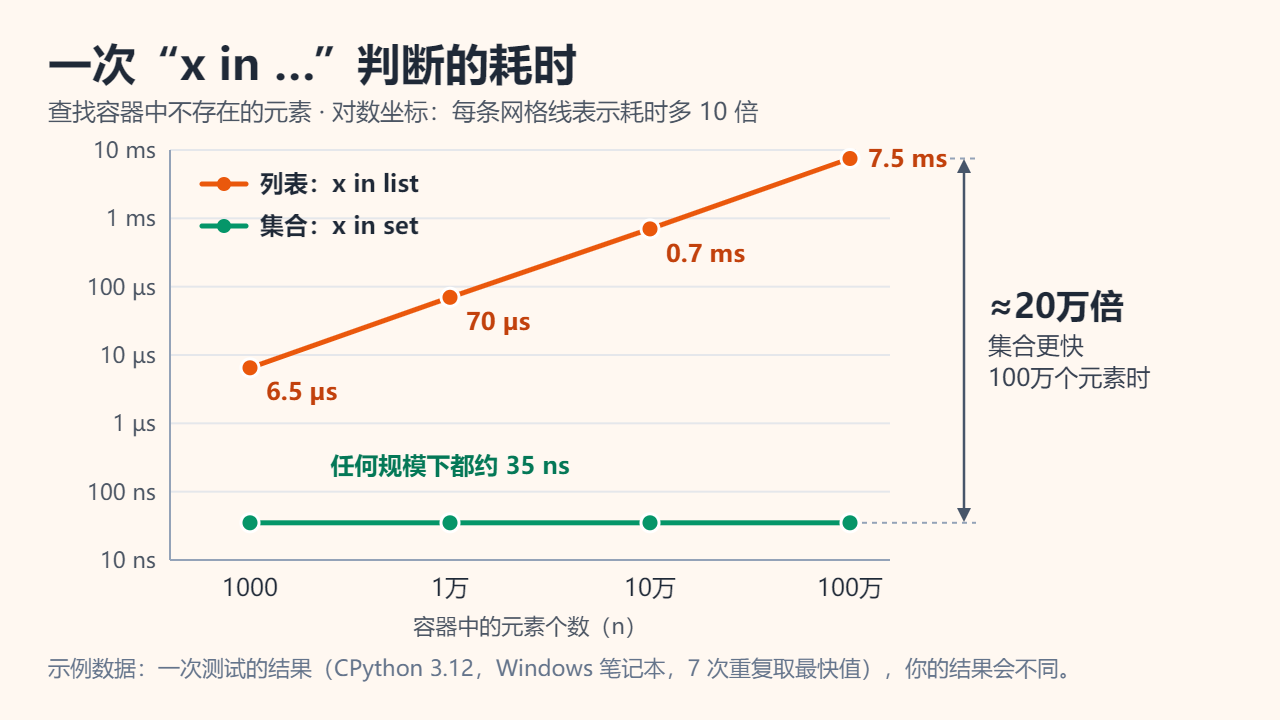
示例数据(一次实测:CPython 3.12,Windows 笔记本,查找容器中不存在的数,重复 7 次取最快值):列表在 1000 个元素时约 6.5 微秒(µs),1万个时约 70 µs,10万个时约 0.7 毫秒(ms),100万个时约 7.5 ms;集合在任何规模下都约 35 纳秒(ns),100万个元素时快了约20万倍。你测出的数字会不同,规律不变:元素多 10 倍,列表耗时约多 10 倍,集合几乎不变。
实用做法:要反复做成员检测,就先用 allowed = set(big_list) 转换一次,之后都查集合。建集合要遍历一遍数据,只查一次并不划算。
常见错误
- 用
{}创建空集合。得到的是字典,调用.add()会抛出 AttributeError。 - 单元素元组漏写逗号。
("admin")只是字符串,循环得到的是一个个字母。 - 用列表当字典键或集合元素。会抛出
TypeError: unhashable type: 'list',先用tuple()转换。 - 一边遍历一边修改容器。在
for x in nums中删除列表元素会漏掉元素:这样删除[1, 2, 2, 3]里的所有 2,结果是[1, 2, 3]。遍历时增删字典的键会抛出 RuntimeError(“dictionary changed size during iteration”),集合同理。应另建新容器,如[x for x in nums if x != 2](得到[1, 3]),或遍历副本,如list(d)。 - 以为元组的内容永远不变。元组本身固定,但里面的列表仍可修改,这样的元组也无法哈希。
- 在循环里反复查大列表。几千次
if user in banned_list是典型的隐蔽性能问题,换成集合即可。
常见问题
元组比列表快吗?
元组略省内存,但差别通常不值得在意。在 64 位 CPython 3.12 上,sys.getsizeof((1, 2, 3)) 为 64 字节,sys.getsizeof([1, 2, 3]) 为 88 字节。选元组应是因为数据不该改变,而不是为了速度。
Python的字典是有序的吗?
是的。从 Python 3.7 起,字典保证保持插入顺序,遍历时键按添加顺序出现。集合没有这样的保证。
字典可以有重复的键吗?
不可以。给已有的键再赋值只会替换原来的值,所以 {"a": 1, "a": 2} 的结果是 {"a": 2}。值可以重复。
参考资料:Python教程:数据结构;官方文档:内置类型(英文);Python Wiki:TimeComplexity(英文);Python术语对照表。
相关阅读
为帮助理解本文而制作的原创插画。