Token是什么?大模型Token与字数的区别及上下文窗口
本文在AI辅助下由原文翻译而成。请结合原文核对专业术语和公式。
Token(常译作“词元”)是大模型(LLM)读写文本的基本单位,可能是常见单词、单词片段、标点或几位数字,每一块都对应一个ID编号。英文平均每个Token约4个字符、约0.75个单词,100个Token约75个英文单词;中文、日语、韩语平均每个Token装下的字符更少,各家分词器的算法也不同。计费、速率限制,以及要同时装下提问和回答的上下文窗口,都以Token计量。
分词器如何把文字切成Token
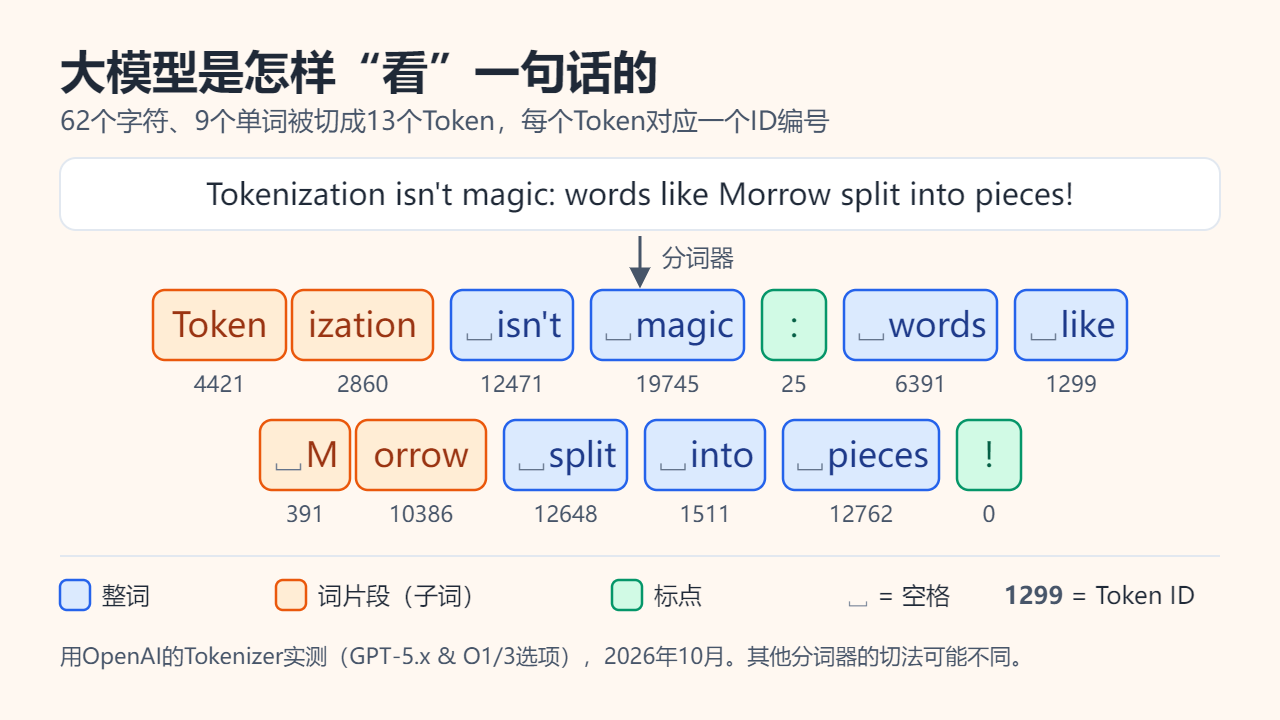
模型并不直接“看到”字母或汉字。分词器(Tokenizer)按固定的词表把文本切成片段,换成对应的ID;模型逐个预测下一个ID,再由分词器还原成文字。图1的例句由OpenAI官方Tokenizer实测(␣表示空格),能看出四种情形:
- 常见单词通常是一个Token,前面的空格也算在内。据OpenAI文档,单词的第一个Token往往以空格开头,所以
token、␣token、␣Token是三个不同的ID。 - 长词或生僻词会被拆开:“Tokenization”切成“Token”+“ization”,“Morrow”切成“␣M”+“orrow”。
- 标点通常单独成块,如冒号和感叹号。
- 数字会被切成几段:日期2026-10-15占6个Token。
字节对编码(BPE):三次合并
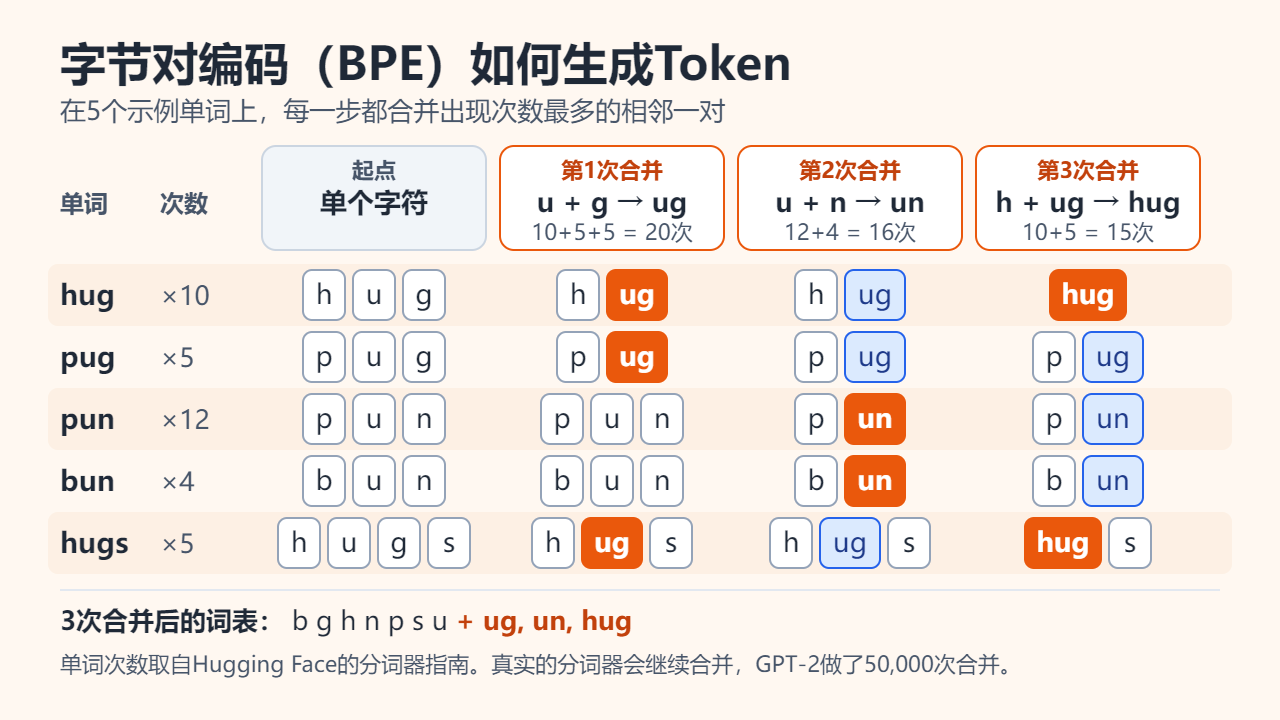
最流行的分词器构建方法是字节对编码(BPE):从单个字符(或256种字节值)出发,在海量文本中反复找出最常相邻的一对,合并成新片段并加入词表。图2中,“u”+“g”出现20次,最先合并;接着是“u”+“n”(16次),再是“h”+“ug”(15次)。底层是字节,所以任何文本(包括表情符号)都能编码,只是罕见文字要花更多Token。
1个Token等于几个单词?英文的常用估算规则
OpenAI和谷歌Gemini API文档给出了英文文本的大致比例:
| 英文估算规则 | 约值(出处) |
|---|---|
| 每个Token的字符数 | 约4个(OpenAI、谷歌) |
| 每个Token的单词数 | 约0.75个(OpenAI) |
| 100个Token对应的单词数 | 约75个(OpenAI);60~80个(谷歌) |
| 1,000个单词对应的Token数 | 约1,333个(1,000÷0.75) |
用图1检验:62个字符÷4≈15.5,9个单词÷0.75=12,实际是13个Token。做预算够用,但代码、网址、数字和非英文文本会明显偏离。
中文、日语、韩语的Token数为什么不一样?1个汉字几个Token
词表取决于分词器训练时见过的文本:语料里较少的语言,长的合并片段也少,句子会被切成更多、更短的Token。字节级分词器还有一层影响:UTF-8里一个汉字、假名或韩文音节占3个字节,词表里没有的字可能拆成两三个字节碎片,在OpenAI的Tokenizer页面显示为“�”。
OpenAI的GPT-4o发布文章用同一句问候语对比了20种语言在新旧分词器下的Token数,图3选了四种。旧分词器下,韩语版本要45个Token,英语版本27个,约为1.7倍;中文版本34个,约为1.3倍。新分词器把韩语降到27个,日语从37个降到26个,中文从34个降到24个,都接近英语的24个。
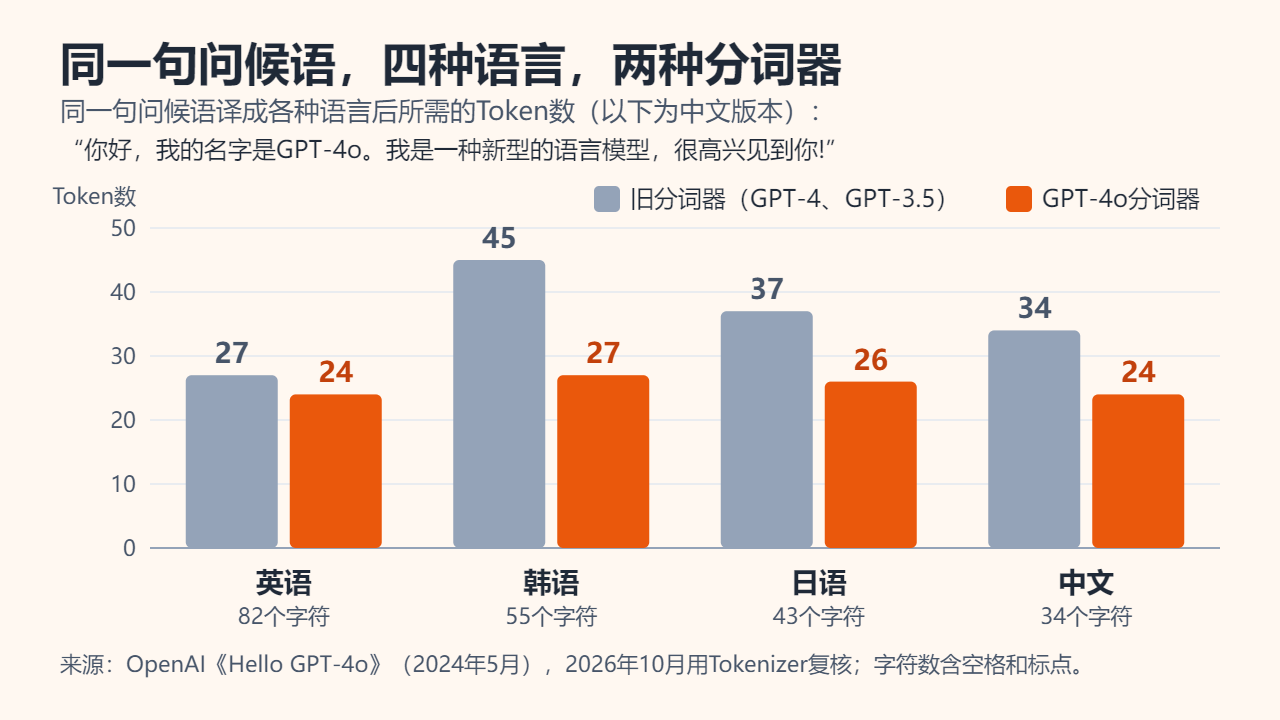
启示有二。第一,英文的“每个Token约4个字符”不能照搬:按GPT-4o分词器计数(空格和标点都算字符),这句话英语每个Token平均约3.4个字符,韩语约2.0个,日语约1.7个,中文约1.4个;旧分词器下,这句中文的34个字符恰好用了34个Token,近似一字一个Token。但这只是单句实测,不是“1个汉字=1个Token”的通用公式。第二,Token数取决于分词器,而不是文本本身:Anthropic的Token计数指南指出,随Claude Opus 4.7推出的分词器,对同样的输入比早期Claude模型多产生约30%的Token。
什么是上下文窗口
上下文窗口(Context Window)是模型一次请求最多能处理的Token数,也是一笔共用的预算:Anthropic的定义是模型生成回答时能参考的全部文本,“包括回答本身”;OpenAI也说,提示词和输出加起来必须放得进最大上下文长度。窗口里装着:
- 系统提示词和工具定义;
- 此前的对话(每发一条新消息,之前各轮都会重发一遍);
- 附带的文档、图片和PDF,同样会转成Token;
- 你的新消息;
- 正在生成的回答,带推理功能的模型还包括“思考”用掉的Token。
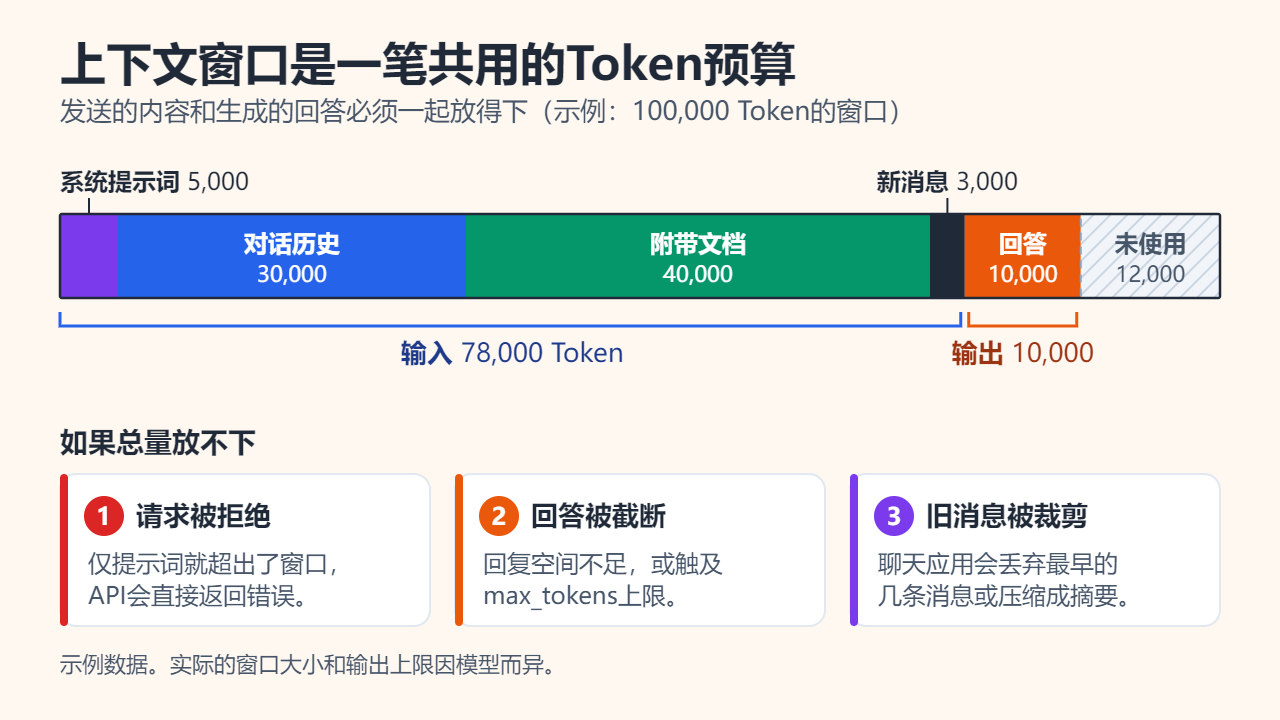
总量放不下时,会出现三种情况之一:
- 请求被拒绝。仅输入就超出窗口时,API报错,例如Claude返回“prompt is too long”(提示词过长)。
- 回答被截断。回复空间不足,或达到设定的输出上限(常叫
max_tokens)时,生成会停下。 - 旧对话被丢弃或压缩。聊天应用可能裁掉最早的消息,或压缩成摘要。
窗口大不等于效果好:Anthropic指出,Token越多,准确性和召回能力越差,聚焦的提示词往往胜过塞满的。
Token数为什么重要:费用、速度和限额
- 费用。API按Token计费,常以每百万Token报价,输入和输出分开定价,输出一般贵好几倍。用API做多轮对话,每一轮都要重发全部历史并按输入计费;提示缓存能降低重复文本的价格,但被缓存的Token仍占用窗口。
- 速度。模型逐个Token地写,生成2,000个Token的回答比200个的慢得多。
- 限额。速率限制、用量配额和最大输出都以Token计量,触到上限的回复会在句子中途截止。
Token怎么计算?准确计数的4种办法
- 快速查看:把文本粘贴到OpenAI公开的Tokenizer页面,会高亮每个Token并给出总数。
- 在代码里处理OpenAI模型,可用开源的
tiktoken库,tiktoken.encoding_for_model()能选出模型对应的编码。 - Claude可调用免费的Token计数接口,Anthropic说明结果是估算值;Gemini用
count_tokens。 - 真实请求发出后,看响应里的
usage字段,其中是实际消耗的输入、输出Token数。
常见问题
空格和标点也算Token吗?
算。单个空格通常并入后面的单词,多余的空格、换行和标点则会增加Token。在OpenAI当前的分词器里,“Hello world”是2个Token,隔两个空格就变成3个。
为什么聊久了,AI会“忘了”开头说的话?
对话已超出上下文窗口,应用丢掉或压缩了最早的几轮。新开对话并附上重点摘要,通常更稳妥。
ChatGPT、Claude和Gemini的Token算法一样吗?
不一样。各模型家族都有自己的分词器,词表和合并规则也不同,所以同一段文字的计数有差异。对比请用各家自己的工具测量。
参考来源:OpenAI API文档:Tokens;OpenAI:Hello GPT-4o;Anthropic Claude文档:上下文窗口;Hugging Face文档:分词算法。
相关阅读
为帮助理解本文而制作的原创插画。