LLMのトークンとは?文字数との違いとコンテキストウィンドウ
この記事はAIの支援を受けて原文を翻訳したものです。専門用語や数式は原文とあわせて確認してください。
トークンとは、大規模言語モデル(LLM)が文章を読み書きするときの単位で、よく使う単語、長い単語の一部、句読点、数桁の数字などの断片に、それぞれID番号を割り当てたものです。英語では1トークンが平均で約4文字、単語の4分の3ほどにあたり、100トークンはおよそ75語です。日本語・韓国語・中国語は1トークンに収まる文字数が少なくなりやすく、数え方もトークナイザーごとに違うため、文字数とトークン数は一致しません。料金、利用制限、入力と出力を合わせて収めるコンテキストウィンドウも、すべてトークン単位です。
トークナイザーは文章をどう分けるのか
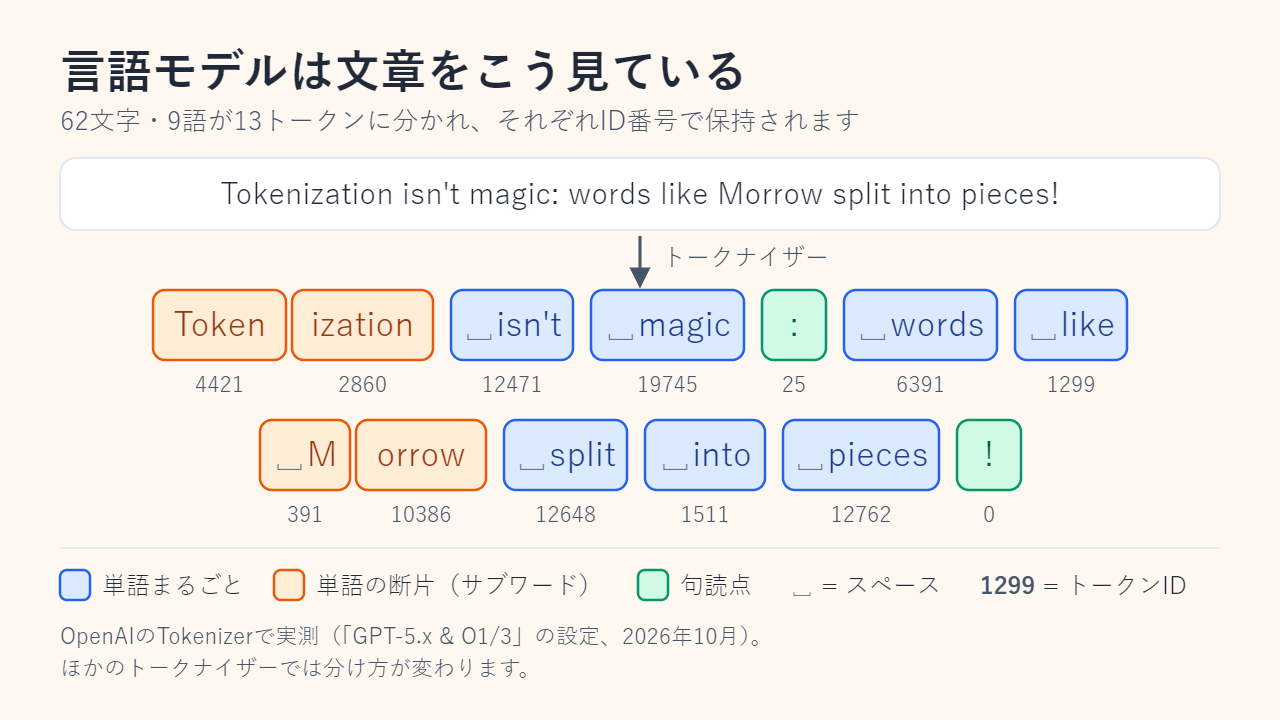
モデルは文字や単語をそのまま見ているわけではありません。トークナイザーが、あらかじめ決まった語彙の中から文章を断片に切り分け、各断片をIDに置き換えます。モデルは次のIDを1つずつ予測し、最後にトークナイザーがIDを文章に戻します。図1には、よくある4つのパターンが出ています。
- よく使う単語は、スペースも含めて1トークンです。OpenAIのドキュメントによると、単語の先頭のトークンは通常スペースから始まるため、「token」「␣token」「␣Token」(␣は半角スペース)は別々のIDになります。
- 長い単語や珍しい単語は断片に分かれます。「Tokenization」は「Token」+「ization」に、「Morrow」は「␣M」+「orrow」に分かれました。
- 句読点は単独のトークンになることが多いです。図1のコロンと感嘆符がそうです。
- 数字は小さな塊に分かれます。日付の「2026-10-15」は6トークンです。
バイトペアエンコーディングを3回のマージで見る
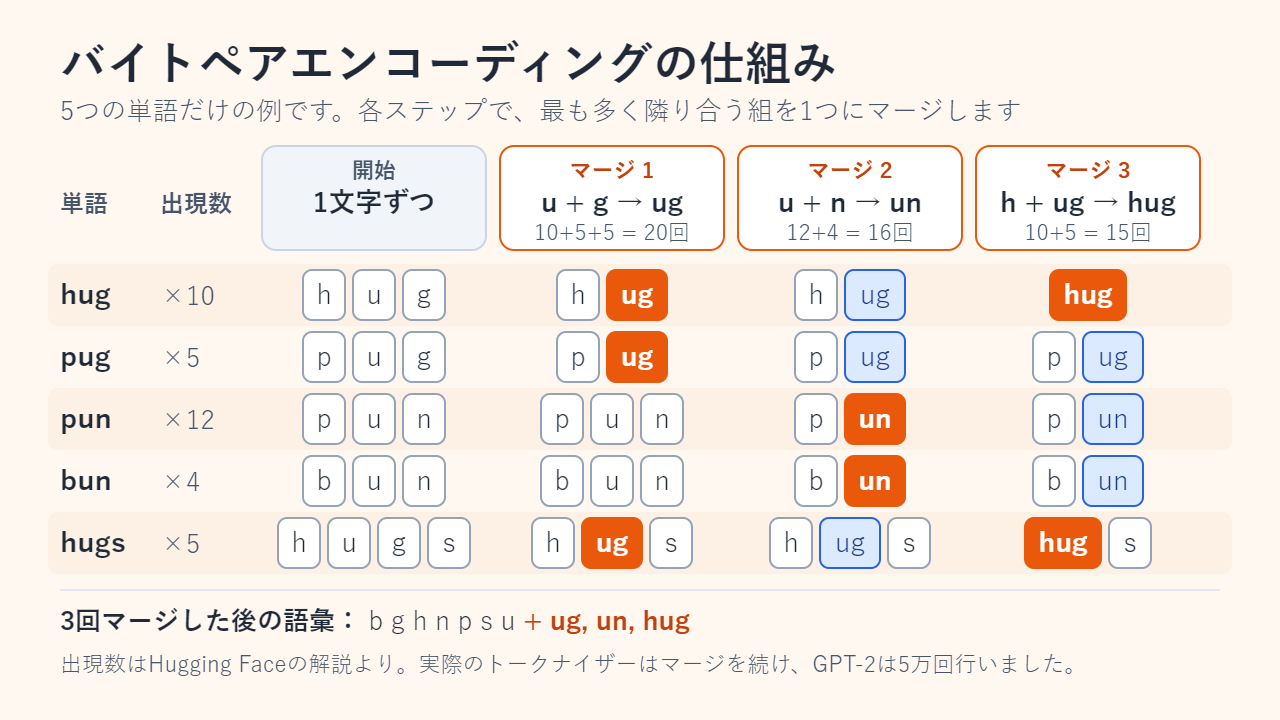
トークナイザーの作り方として最も広く使われているのがバイトペアエンコーディング(BPE)です。学習は1文字ずつ(または256通りのバイト値)から始まり、大量の文章で最も頻繁に隣り合う2つの組を1つにまとめて(マージして)語彙に加える、という操作を繰り返します。図2では、まず「u」+「g」が20回出てくるので最初にマージされ、次に「u」+「n」(16回)、最後に「h」+「ug」(15回)がマージされます。実際のトークナイザーは語彙が目標の大きさになるまでこれを続け、GPT-2は256個のバイトトークンに加えて5万回のマージを行いました。最下層がバイトなので、絵文字を含めどんな文字列も符号化できますが、珍しい文字列ほどトークンを多く使います。
1トークンは何文字・何語?英語の目安
大まかな目安は、OpenAIとGoogleのGemini APIドキュメントが英語について公表しています。
| 英語での目安 | おおよその値 | 出典 |
|---|---|---|
| 1トークンあたりの文字数 | 約4文字 | OpenAI、Google |
| 1トークンあたりの単語数 | 約0.75語 | OpenAI |
| 100トークンあたりの単語数 | 約75語(OpenAI)、60〜80語(Google) | OpenAI、Google |
| 1,000語あたりのトークン数 | 約1,333(1,000÷0.75) | OpenAIの比率から計算 |
図1の文で試してみましょう。62文字÷4なら15.5トークン、9語÷0.75なら12トークンと予測できますが、実際の数は13トークンでした。予算の見積もりには十分な精度です。ただし、コード、URL、数字、英語以外の文章では、この比率からのずれが大きくなります。
日本語・韓国語・中国語でトークン数が文字数と合わない理由
トークナイザーの語彙には、学習に使われた文章の傾向が反映されます。学習データでの割合が小さい言語ほど、長くまとまった断片が語彙に入りにくく、文が細かく短いトークンに分かれます。バイト単位のトークナイザーには、もう1つ事情があります。韓国語のハングル1字も、日本語や中国語の漢字・かな1字も、UTF-8ではそれぞれ3バイトです。語彙にない文字は2〜3個のバイト断片に分かれることがあり、OpenAIのTokenizerではこれが「�」と表示されます。
OpenAIのGPT-4oの発表ページには、同じあいさつ文を20言語で数えた結果が、旧・新両方のトークナイザーについて載っています。図3はそのうち4言語です。旧トークナイザーでは、英語の27トークンに対して韓国語は45トークンで、約1.7倍かかりました。新トークナイザーでは韓国語が27、日本語が37から26、中国語が34から24に減り、英語の24に近づいています。
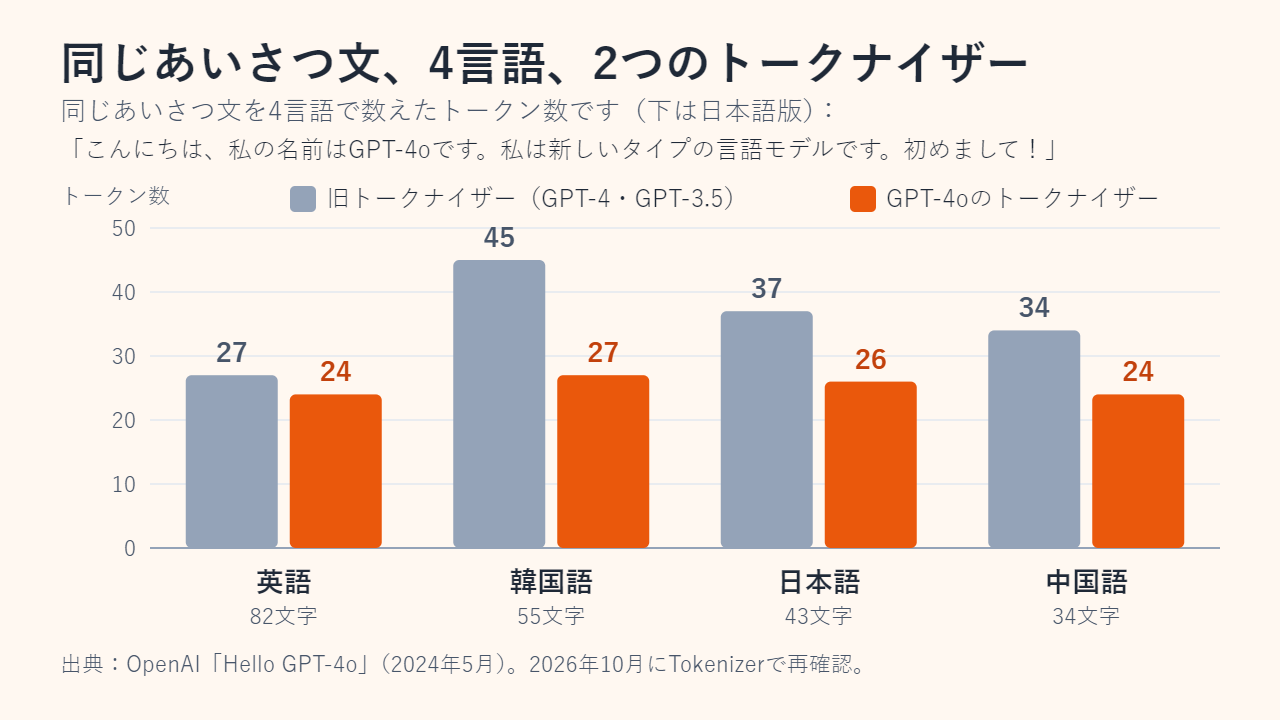
ここから2つのことが言えます。1つ目は、英語の「1トークン約4文字」という目安が、そのままでは日本語に当てはまらないことです。GPT-4oのトークナイザーで数えると、スペースと句読点を含めて、1トークンあたりの文字数は英語が3.4、韓国語が2.0、日本語が1.7、中国語が1.4でした。ただし、これは1つのあいさつ文から計算した値なので、「日本語は1文字が1トークン」のような一律の換算には使わず、自分の文章で測ってください。
2つ目は、トークン数がテキストそのものではなく、トークナイザーとセットで決まる数字だということです。たとえばAnthropicのトークンカウントのガイドは、Claude Opus 4.7で導入されたトークナイザーが、それ以前のClaudeモデルより、同じ入力で約30%多くのトークンを生成すると説明しています。
コンテキストウィンドウとは?入力と出力で共有する枠
コンテキストウィンドウとは、モデルが1回のリクエストで扱えるトークン数の上限です。入力と出力は1つの予算を分け合います。Anthropicはこれを「応答そのものを含め、モデルが参照できるすべてのテキスト」と説明し、OpenAIも、プロンプトと出力を合わせてモデルの最大コンテキスト長に収める必要があると述べています。ウィンドウの中には、次のものが入ります。
- システムプロンプトと、ツールの定義
- ここまでの会話(チャットは毎回、過去のやり取りも再送します)
- 添付した文書・画像・PDF。これらもトークンに変換されます
- 今回送る新しいメッセージ
- 生成中の回答。推論(thinking)用のトークンを使うモデルでは、その分も含まれます
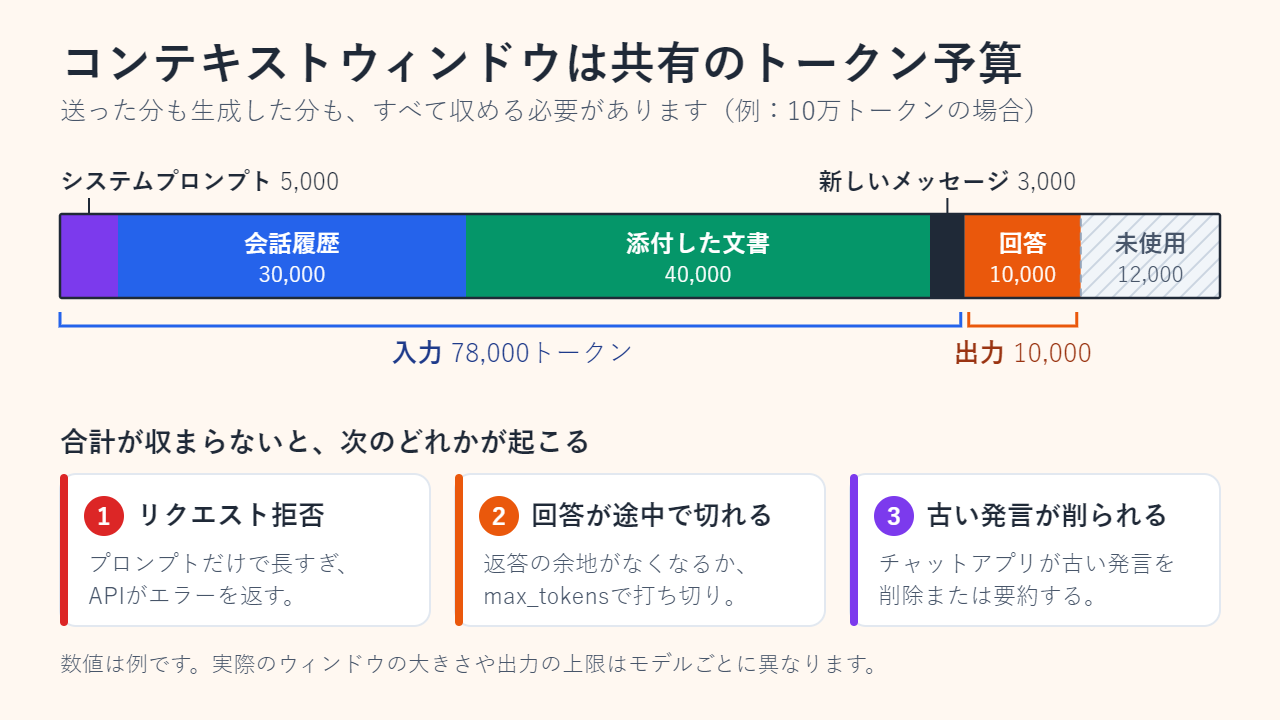
合計が収まらないと、次の3つのうちどれかが起こります。
- リクエストが拒否されます。入力だけでウィンドウを超えると、APIはエラーを返します。ClaudeのAPIなら「プロンプトが長すぎる」というエラーです。
- 回答が途中で切れます。返答の余地がなくなるか、自分で設定した出力の上限(多くは
max_tokensと呼ばれます)に達すると、生成はそこで止まります。 - 古い発言が削られるか、要約されます。チャットアプリは、いちばん古いメッセージを外したり、要約に圧縮したりすることがあります。
ウィンドウは大きいほど良い、とは限りません。Anthropicは、トークン数が増えるほど正確さと情報の取り出しやすさ(リコール)が落ちていくと説明しています。要点を絞ったプロンプトが、詰め込みすぎに勝つこともよくあります。
トークン数が重要な理由:料金・速度・上限
- 料金。API利用料は通常、100万トークンあたりの単価で示され、入力と出力で別料金です。出力のほうが数倍高いのが一般的です。APIでチャットを作ると、会話のたびに履歴全体が入力として再送され、その分も課金されます。プロンプトキャッシュは繰り返すテキストの料金を下げますが、ウィンドウの占有は変わりません。
- 速度。モデルは1トークンずつ書くので、2,000トークンの回答は200トークンの回答よりずっと時間がかかります。
- 上限。レート制限、利用枠、出力の上限はトークンで数えられます。上限に達した返答は、文の途中で終わります。
トークン数の計算方法:正確に数える4つの方法
- 手早く確認するなら、OpenAIが公開しているTokenizerのページに文章を貼り付けます。トークンごとにハイライトされ、合計も表示されます。エンコーディングの選択肢(「GPT-5.x & O1/3」など)を切り替えて比べることもできます。
- OpenAIのモデルをコードで数えるなら、オープンソースの
tiktokenライブラリを使い、tiktoken.encoding_for_model()でモデルに合ったエンコーディングを選びます。 - Claudeでは、無料のトークンカウント用エンドポイントを呼び出します(結果は推定値とされています)。Geminiでは
count_tokensを呼び出します。 - 実際のリクエストの後は、レスポンスの
usageフィールドを確認します。ここに、実際の入力と出力のトークン数が入っています。
よくある質問
スペースや句読点もトークンに数えられますか?
はい。スペース1つは多くの場合、次の単語にくっついて数えられますが、余分なスペース、改行、句読点はトークンを増やすことがあります。OpenAIの現行トークナイザーでは、「Hello world」は2トークンですが、同じ2語の間にスペースを2つ入れると3トークンになります。
長いチャットで、最初に話した内容を忘れるのはなぜですか?
会話がコンテキストウィンドウを超え、アプリが最初のほうのやり取りを削ったり、要約に置き換えたりしたためです。大事な点を短くまとめて新しいチャットを始めるほうが、うまくいきがちです。
ChatGPT、Claude、Geminiで、トークンの数え方は同じですか?
いいえ。モデルの系列ごとに独自のトークナイザーを使うので、同じ文章でも数が変わります。比較するなら、各モデルの専用ツールで同じ文章を測ってください。
日本語で使うと、英語より料金が高くなりますか?
従量課金のAPIでは、トークン数が多ければ料金も増えます。差の大きさはトークナイザー次第で、図3のあいさつ文では、旧トークナイザーが日本語37・英語27、GPT-4oのトークナイザーが日本語26・英語24トークンでした。実際の数は自分の文章で確かめてください。
出典:OpenAI APIドキュメント「Key concepts」、OpenAI「Hello GPT-4o」、Anthropic Claudeドキュメント「Context windows」、Hugging Face Transformersドキュメント「Tokenization algorithms」。
関連記事
本文の理解を助けるために制作したオリジナルイラストです。