LLM 토큰이란? 글자 수와 다른 이유, 컨텍스트 윈도우
이 글은 AI의 도움을 받아 원문을 번역한 글입니다. 전문 용어와 수식은 원문과 함께 확인해 주세요.
토큰(token)은 거대 언어 모델(LLM)이 읽고 쓰는 텍스트 조각으로, 자주 쓰는 단어나 긴 단어의 일부, 문장부호, 몇 자리 숫자가 각각 하나의 ID 번호로 저장됩니다. 영어에서는 토큰 하나가 평균 약 4글자(단어의 약 4분의 3)여서 100토큰이 약 75단어이지만, 한국어·일본어·중국어는 토큰 하나에 담기는 글자 수가 보통 더 적고 토크나이저마다 세는 값도 다릅니다. 요금, 사용량 제한, 질문과 답변이 함께 들어가는 컨텍스트 윈도우가 모두 토큰 기준입니다.
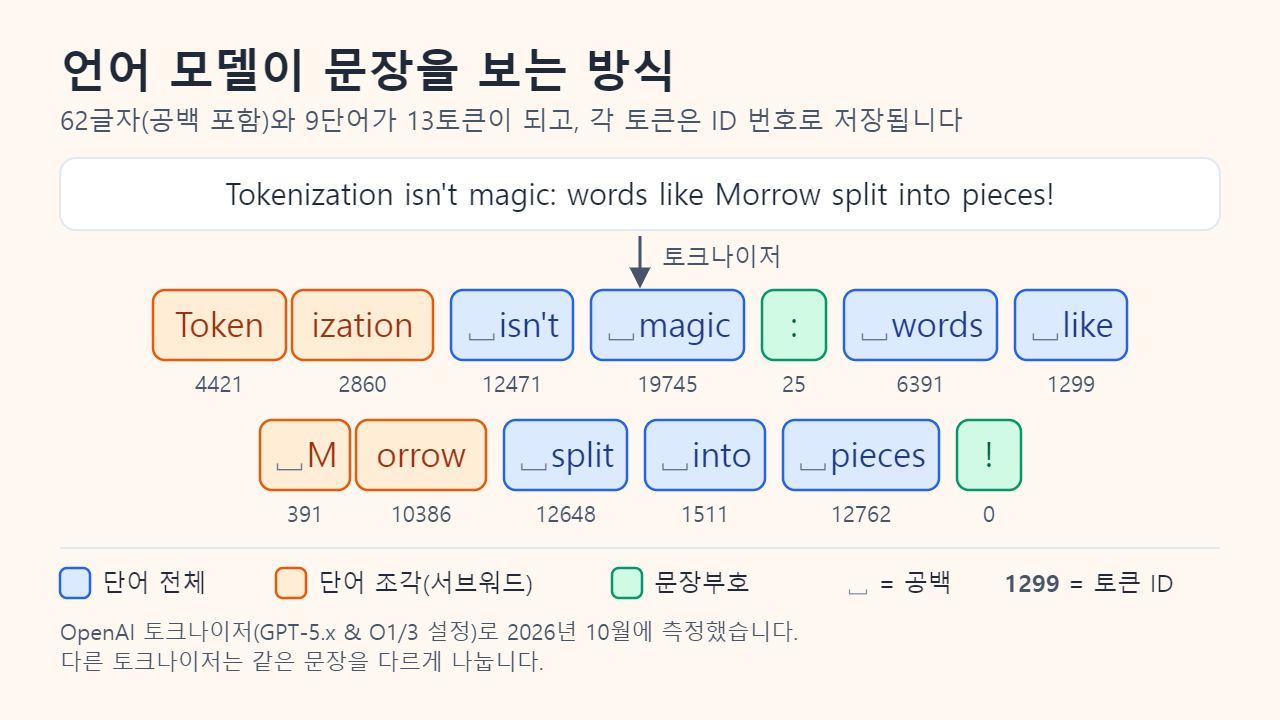
토크나이저는 텍스트를 토큰으로 어떻게 나눌까
모델은 글자나 단어를 직접 보지 않습니다. 토크나이저(tokenizer)가 정해진 어휘 목록에 맞춰 텍스트를 조각내 ID 번호를 붙이면, 모델은 다음 ID를 한 토큰씩 예측하고 토크나이저가 그 ID를 다시 글자로 되돌립니다. 그림 1(␣는 공백 표시)과 함께 흔한 패턴 네 가지를 살펴보겠습니다.
- 흔한 단어는 앞 공백을 달고 토큰 하나가 됩니다. OpenAI 문서에 따르면 단어의 첫 토큰은 보통 공백으로 시작합니다. 그래서 공백 없는 token, 공백이 붙은 ␣token, 대문자로 시작하는 ␣Token은 서로 다른 ID를 가진 세 토큰입니다.
- 길거나 드문 단어는 조각으로 나뉩니다. ‘Tokenization’은 ‘Token’ + ‘ization’, ‘Morrow’는 ‘␣M’ + ‘orrow’가 됩니다.
- 문장부호는 대개 혼자 토큰이 됩니다. 그림의 콜론(:)과 느낌표(!)가 그 예입니다.
- 숫자는 몇 자리씩 끊깁니다. 날짜 2026-10-15는 토큰 6개입니다.
바이트 페어 인코딩(BPE): 세 번의 병합으로 보는 원리
토크나이저를 만드는 가장 대표적인 방법이 바이트 페어 인코딩(BPE)입니다. 글자 하나하나(또는 256가지 바이트 값)에서 출발해, 방대한 텍스트에서 서로 이웃해 가장 자주 나타나는 글자 쌍을 하나로 합쳐 어휘 목록에 추가하는 과정을 반복합니다. 그림 2에서는 ‘u’+‘g’가 20번으로 가장 많아 먼저 합쳐지고, 이어서 ‘u’+‘n’(16번), ‘h’+‘ug’(15번)가 차례로 합쳐집니다. 실제 토크나이저는 어휘가 목표 크기에 이를 때까지 병합을 이어 가며, GPT-2는 256개의 바이트 토큰 위에 5만 번의 병합을 얹었습니다. 맨 아래 단위가 바이트라서 이모지 같은 낯선 글자도 인코딩할 수 있고, 드문 텍스트는 그만큼 토큰이 더 듭니다.
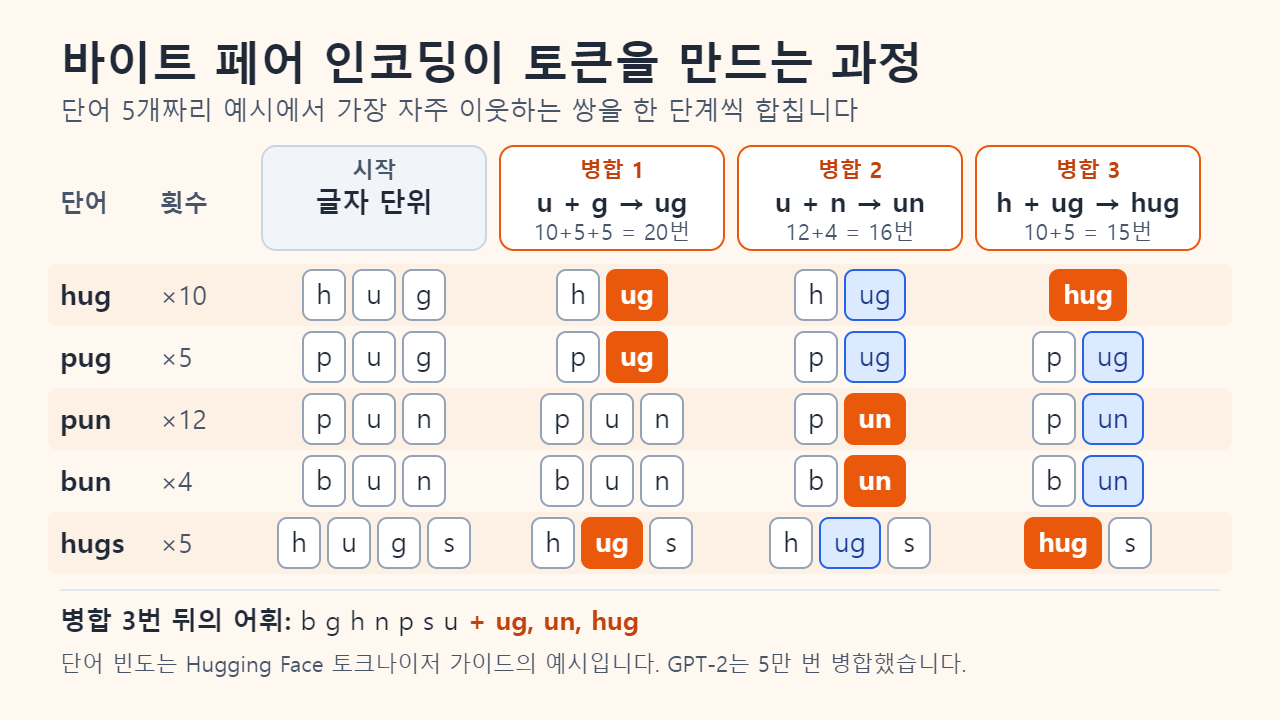
토큰 1개는 몇 글자, 몇 단어일까: 영어 기준 경험칙
대략적인 계산에는 OpenAI와 Google Gemini API 문서가 영어 기준으로 제시한 비율을 씁니다.
| 경험칙(영어 기준) | 대략적인 값 | 제시한 곳 |
|---|---|---|
| 토큰 1개당 글자 수 | 약 4글자 | OpenAI, Google |
| 토큰 1개당 단어 수 | 약 0.75단어 | OpenAI |
| 100토큰당 단어 수 | 약 75단어(OpenAI), 60~80단어(Google) | OpenAI, Google |
| 1,000단어당 토큰 수 | 약 1,333토큰(1,000 ÷ 0.75) | OpenAI의 비율로 계산한 값 |
그림 1의 문장으로 검산해 보면 62글자 ÷ 4 = 15.5토큰, 9단어 ÷ 0.75 = 12토큰으로 예측되는데 실제는 13토큰입니다. 예산을 잡기에는 충분하지만, 코드·URL·숫자·영어가 아닌 언어에서는 비율이 크게 어긋납니다.
한국어·일본어·중국어는 왜 토큰 수가 다르게 나올까
토크나이저의 어휘는 학습에 쓴 텍스트를 그대로 반영합니다. 그 텍스트에서 비중이 작았던 언어는 길게 합쳐진 조각이 적어서, 같은 문장이 더 짧은 토큰 여러 개로 쪼개집니다. 바이트 단위 토크나이저에는 한 가지가 더 있습니다. UTF-8에서 한글 음절 하나나 한자·가나 한 글자는 3바이트인데, 어휘에 없는 글자는 바이트 조각 두세 개로 갈라질 수 있고, OpenAI 토크나이저 화면에는 이런 조각이 �로 표시됩니다.
OpenAI의 GPT-4o 발표 글은 같은 인사말을 20개 언어로 옮겨 이전 토크나이저와 새 토크나이저로 각각 센 결과를 실었고, 그림 3은 그중 네 개 언어입니다. 이전 토크나이저에서 한국어 버전은 45토큰으로, 영어(27토큰)의 약 1.7배였습니다. 새 토크나이저에서는 한국어가 27토큰, 일본어가 37토큰에서 26토큰, 중국어가 34토큰에서 24토큰으로 줄어 영어의 24토큰에 가까워졌습니다.
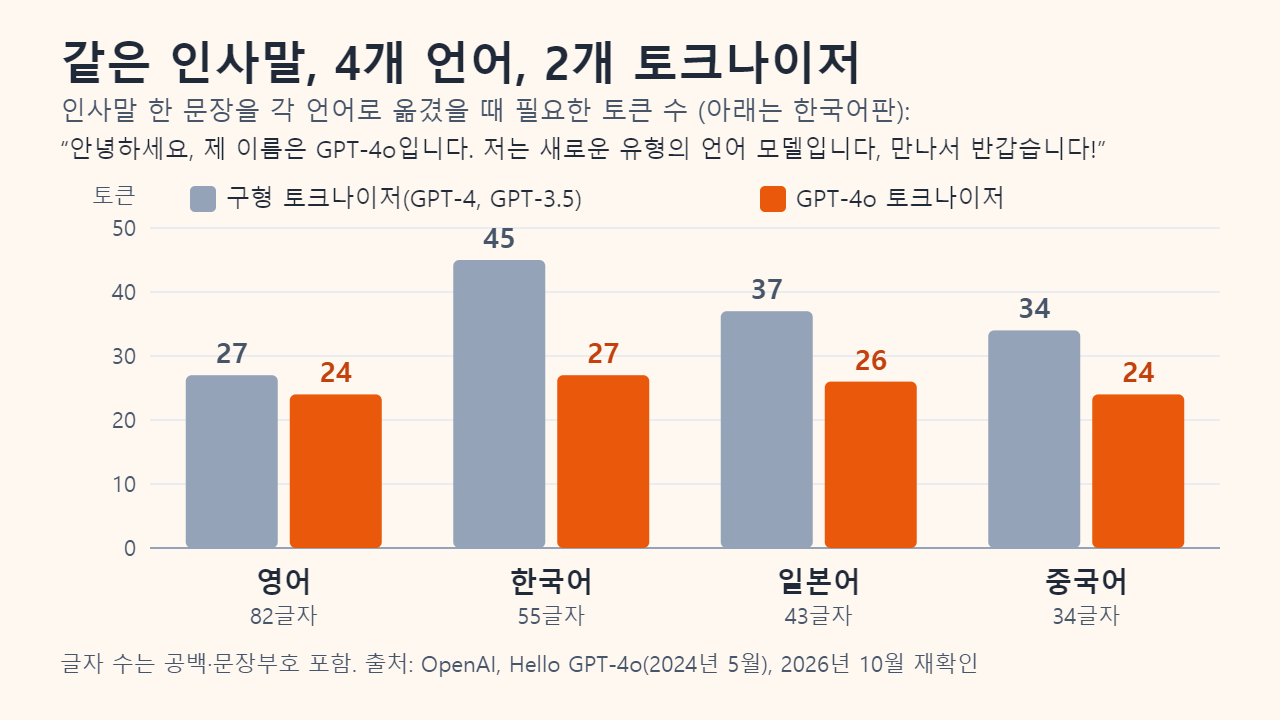
여기서 짚을 점은 두 가지입니다. 첫째, 영어의 ‘토큰당 4글자’ 규칙은 다른 언어에 그대로 옮겨지지 않습니다. 그림 3의 GPT-4o 토크나이저 수치(공백·문장부호 포함)로 토큰당 평균 글자 수를 구하면 영어 약 3.4, 한국어 약 2.0, 일본어 약 1.7, 중국어 약 1.4입니다. 다만 인사말 한 문장에서 잰 값이므로 ‘한글 한 글자는 몇 토큰’ 같은 고정 공식으로 외우지는 마세요. 둘째, 토큰 수는 텍스트가 아니라 토크나이저에 딸린 값입니다. 예를 들어 Anthropic의 토큰 계산 가이드는 Claude Opus 4.7과 함께 도입된 토크나이저가 같은 입력에 대해 이전 Claude 모델보다 대략 30퍼센트 많은 토큰을 만든다고 설명합니다.
컨텍스트 윈도우란? 입력과 출력이 함께 쓰는 한도
컨텍스트 윈도우(context window)는 모델이 한 번의 요청에서 다룰 수 있는 최대 토큰 수이며, 입력과 출력이 하나의 예산을 나눠 씁니다. Anthropic은 응답까지 포함해 모델이 참고할 수 있는 모든 텍스트를 컨텍스트 윈도우로 정의하고, OpenAI는 프롬프트와 출력을 합친 길이가 모델의 최대 컨텍스트 길이 안에 들어와야 한다고 설명합니다. 윈도우에는 다음이 들어갑니다.
- 시스템 프롬프트와 도구 정의
- 지금까지의 대화: 채팅은 새 메시지를 보낼 때마다 앞선 대화를 다시 보내기 때문입니다.
- 첨부한 문서·이미지·PDF: 모두 토큰으로 변환됩니다.
- 새로 입력한 메시지
- 생성 중인 답변: 추론(‘생각’) 토큰을 쓰는 모델이라면 그 토큰도 포함됩니다.
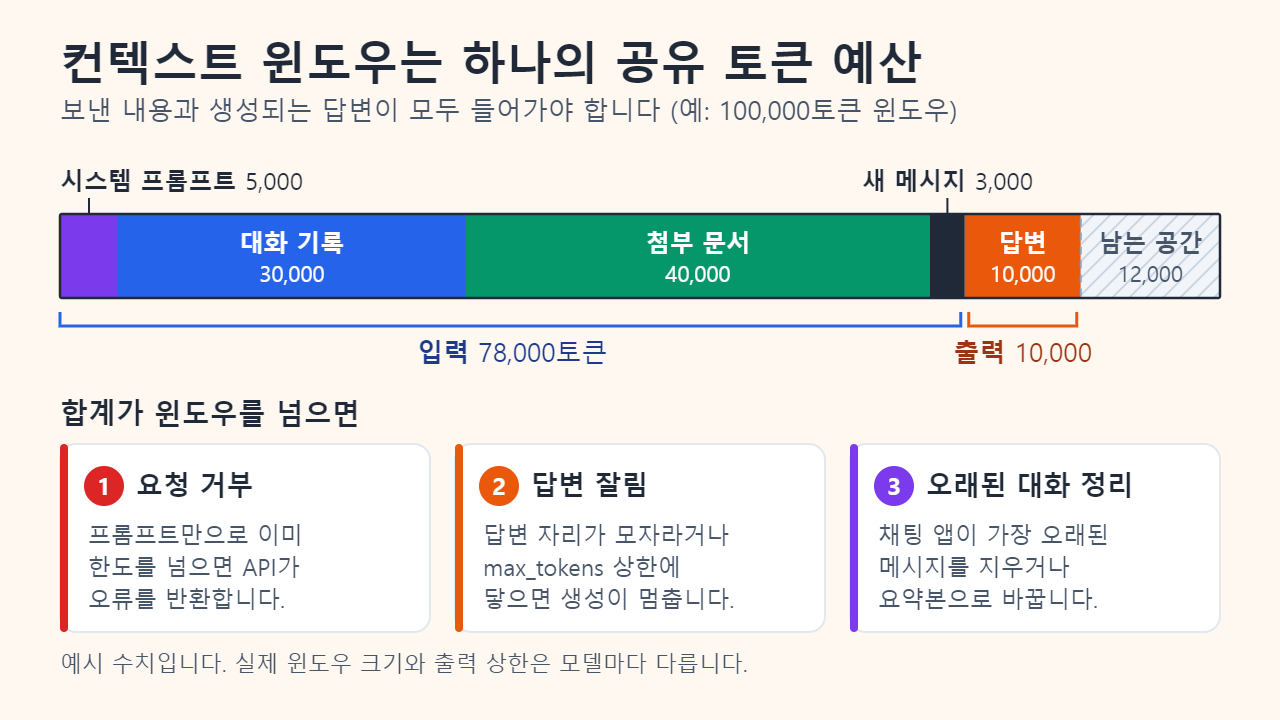
합계가 윈도우를 넘으면 다음 셋 중 하나가 일어납니다.
- 요청이 거부됩니다. 입력만으로 윈도우를 넘으면 API가 오류를 반환하며, Claude API는 프롬프트가 너무 길다는 오류를 돌려줍니다.
- 답변이 잘립니다. 답변이 들어갈 자리가 모자라거나 직접 정한 출력 상한(흔히
max_tokens)에 닿으면 생성이 그대로 멈춥니다. - 오래된 대화가 삭제되거나 요약됩니다. 채팅 앱은 가장 앞쪽 메시지를 잘라 내거나 요약본으로 압축하기도 합니다.
윈도우가 크다고 무조건 좋지는 않습니다. Anthropic은 토큰 수가 늘수록 정확도와 기억력(recall)이 떨어진다고 밝히므로, 필요한 내용만 담은 프롬프트가 잔뜩 채운 프롬프트보다 나을 때가 많습니다.
토큰 수가 중요한 이유: 비용, 속도, 사용량 제한
- 비용. API는 토큰 단위로 과금하며 보통 100만 토큰당 가격을 입력과 출력 따로 표시합니다. 출력 토큰이 대체로 몇 배 더 비쌉니다. API로 만든 채팅은 매 턴마다 대화 전체가 입력으로 다시 전송되고 다시 과금됩니다. 프롬프트 캐싱은 반복되는 텍스트의 가격을 낮춰 주지만, 캐시된 토큰도 윈도우 자리는 차지합니다.
- 속도. 모델은 토큰을 하나씩 만들어 내므로 2,000토큰짜리 답변은 200토큰짜리보다 훨씬 오래 걸립니다.
- 한도. 사용량 제한(레이트 리밋), 사용 할당량, 최대 출력 토큰도 모두 토큰 단위이고, 상한에 닿은 답변은 문장 중간에서 끝납니다.
토큰 수를 정확히 계산하는 방법
- 간단히 확인하려면 OpenAI의 공개 토크나이저(Tokenizer) 페이지에 글을 붙여 넣으세요. 토큰이 색으로 구분되고 전체 개수가 표시됩니다.
- OpenAI 모델을 코드로 계산할 때는 오픈소스 라이브러리
tiktoken을 씁니다.tiktoken.encoding_for_model()이 모델에 맞는 인코딩을 골라 줍니다. - Claude는 무료 토큰 계산 엔드포인트를 호출하면 되며, Anthropic은 그 결과를 추정치라고 설명합니다. Gemini는
count_tokens를 호출합니다. - 실제 요청을 보낸 뒤에는 응답의
usage필드를 확인하세요. 실제로 쓰인 입력·출력 토큰 수가 나옵니다.
자주 묻는 질문
공백과 문장부호도 토큰으로 셀까요?
네. 공백 하나는 보통 다음 단어에 붙어 함께 계산되지만, 추가 공백이나 줄바꿈, 문장부호는 토큰을 늘릴 수 있습니다. OpenAI의 최신 토크나이저에서 영어 ‘Hello world’는 2토큰이고, 두 단어 사이를 두 칸 띄우면 3토큰입니다.
대화가 길어지면 처음에 한 말을 왜 잊어버리나요?
대화가 컨텍스트 윈도우를 넘어서 앱이 앞쪽 대화를 삭제하거나 요약했기 때문입니다. 중요한 내용만 짧게 정리해 새 대화를 시작하는 편이 대체로 낫습니다.
ChatGPT, Claude, Gemini는 토큰을 같은 방식으로 셀까요?
아닙니다. 모델 계열마다 고유한 토크나이저를 쓰므로 같은 글도 토큰 수가 다릅니다. 비교하려면 같은 글을 각 모델의 도구로 따로 재야 합니다.
참고 자료: OpenAI API 문서, 핵심 개념(토큰); OpenAI, Hello GPT-4o(언어별 토큰화); Anthropic Claude 문서, 컨텍스트 윈도우; Hugging Face Transformers 문서, 토큰화 알고리즘.
함께 읽으면 좋은 글
본문의 이해를 돕기 위해 제작한 설명용 삽화입니다.